
Raport · 10 listopada 2026
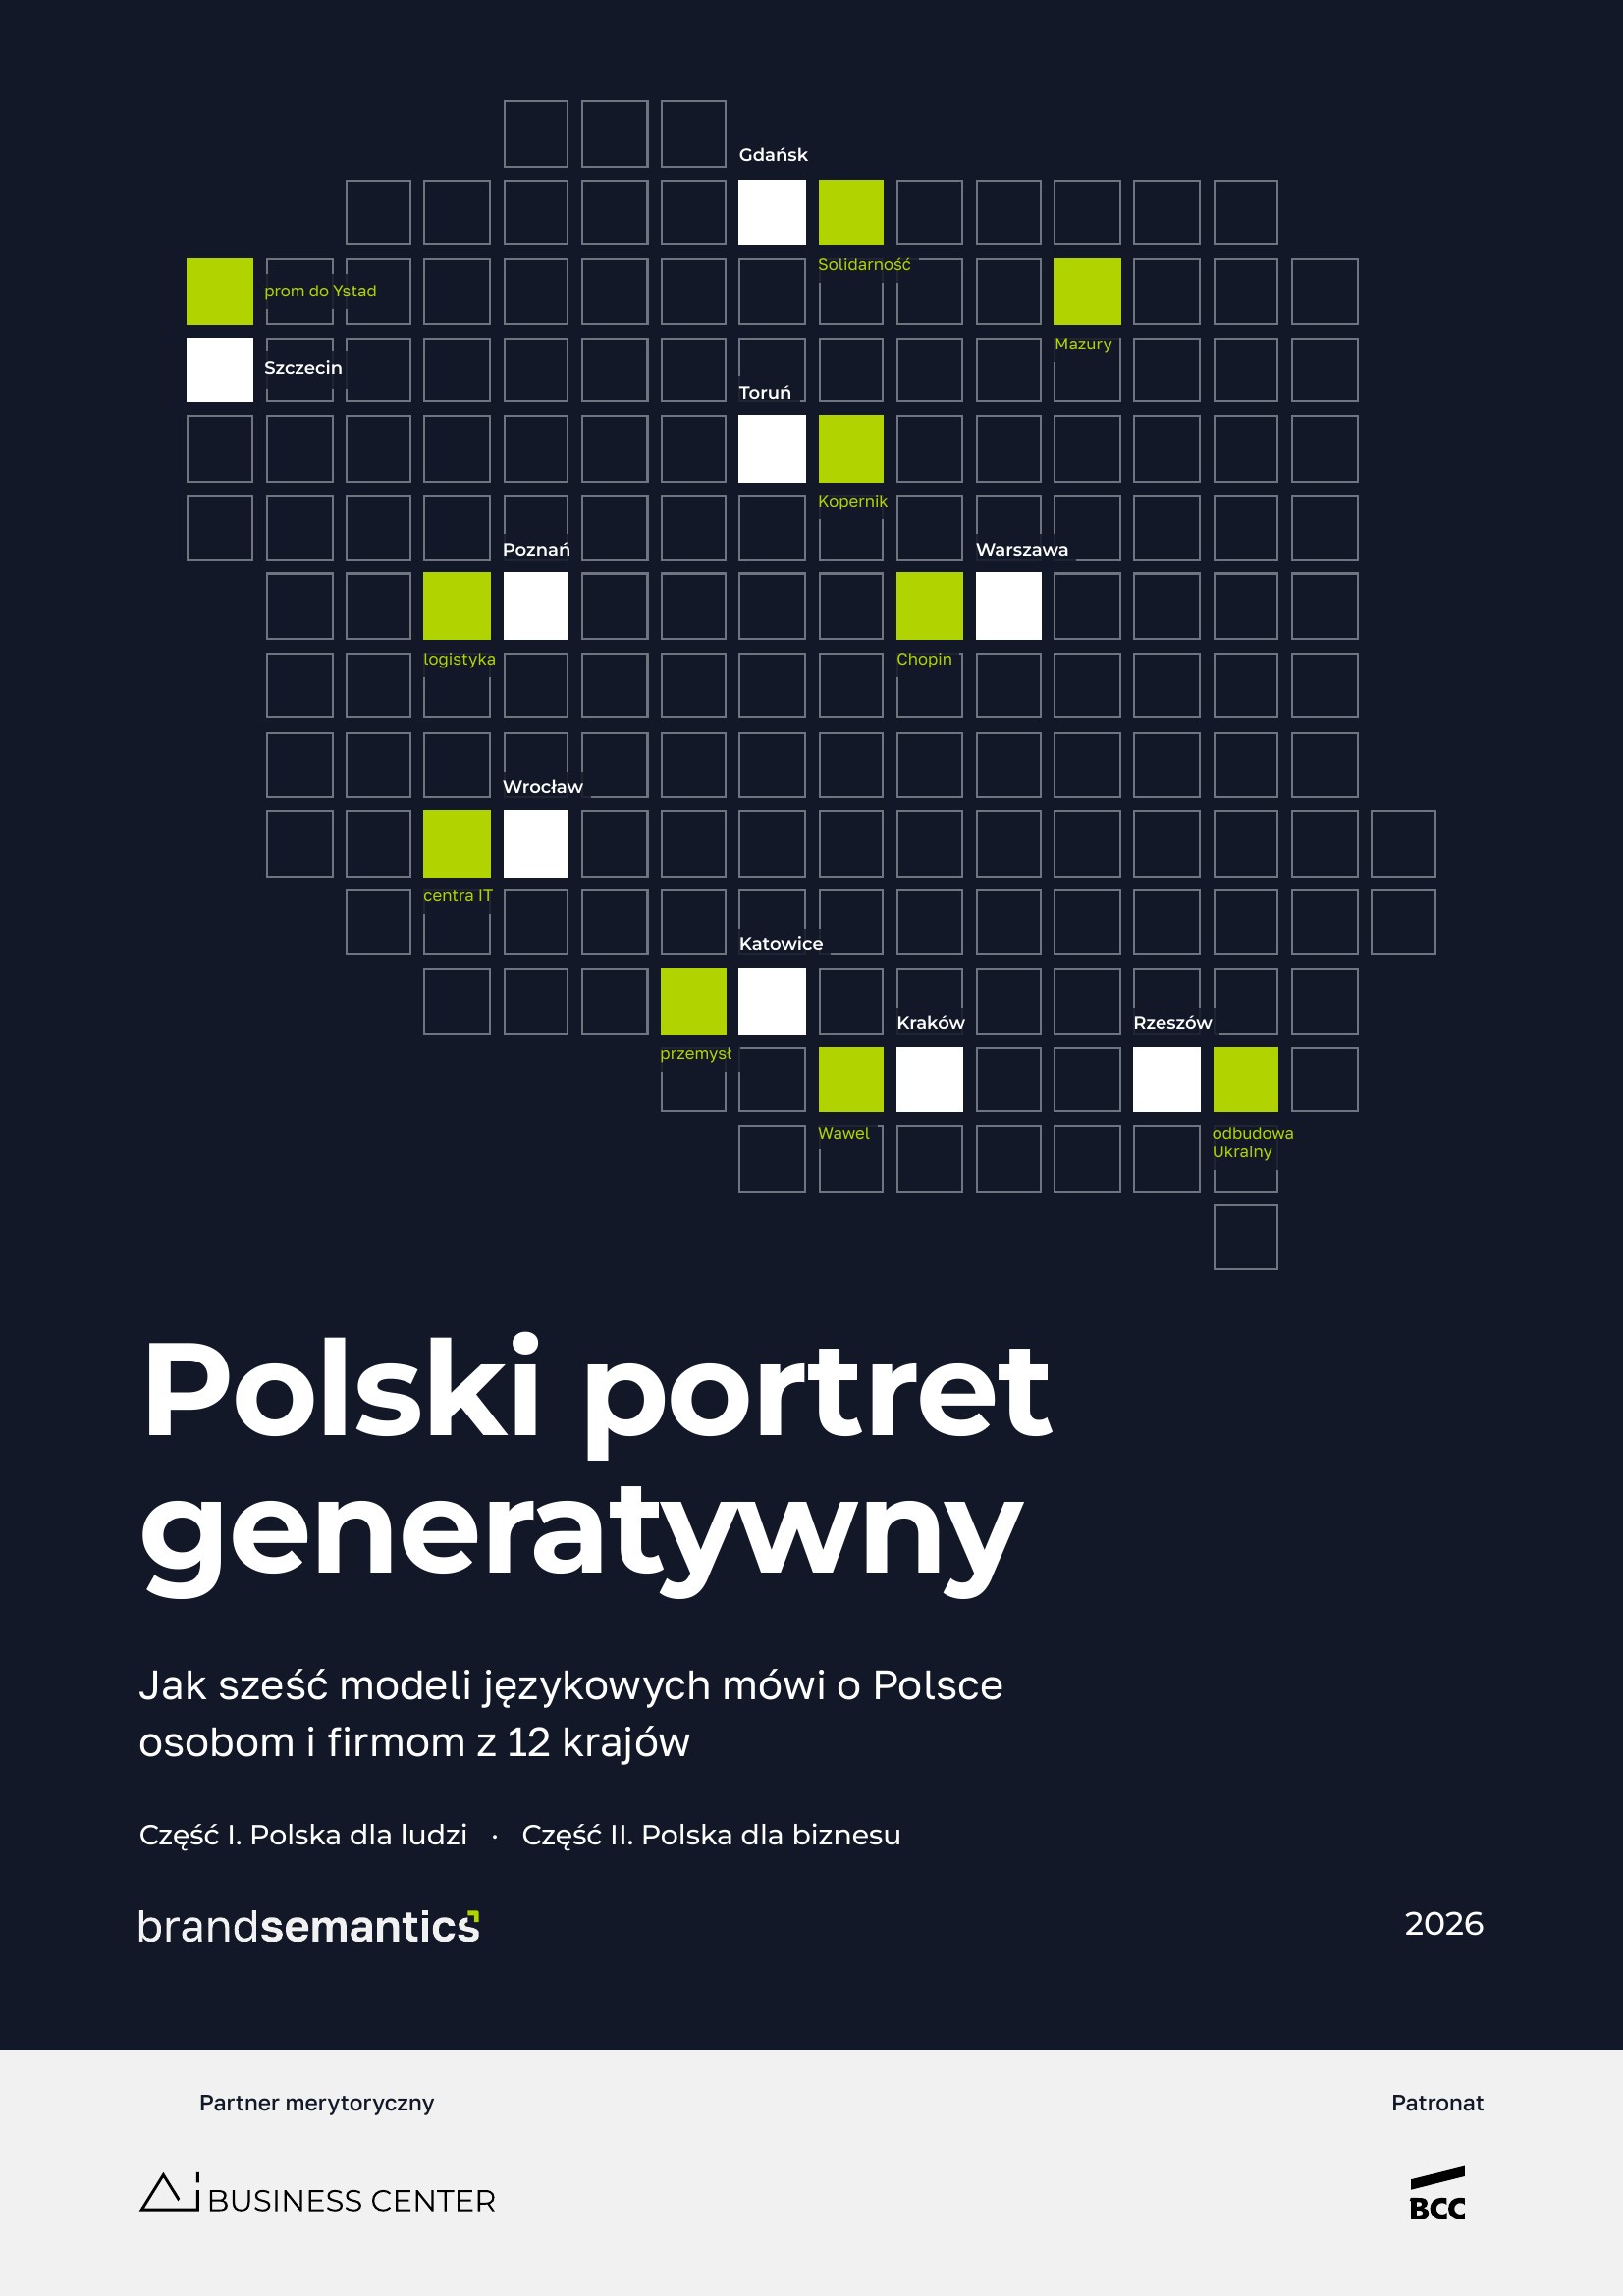
Polski Portret Generatywny
Pierwszy pomiar, jak sześć modeli językowych mówi o Polsce osobom i firmom z 12 krajów
Gdy pytanie nie wymienia Polski, modele językowe wprowadzają ją same w siedmiu odpowiedziach na dziesięć, ale w pytaniach o Europę „w ogóle” w mniej niż co drugiej, a gdy już ją wprowadzą, częściej ją wymieniają, niż polecają. Firmom mówią o Polsce prawie zawsze, także bez pytania o nią: pada w 98 odpowiedziach na 100. Rola zależy jednak od obszaru decyzji, a w logistyce Polska przegrywa na geografii, nie na kosztach. To główne wnioski raportu „Polski Portret Generatywny”, czyli mapy semantycznej Polski w odpowiedziach sześciu modeli językowych.
Mapa semantyczna Polski
Raport w jednej mapie: miasta, miejsca, nazwiska, branże i instytucje, które modele językowe łączą z Polską. Przybliżaj mapę i klikaj pola: przy każdym jest zdanie z raportu, rozdział i strona w PDF.
Otwórz mapęDziała także na telefonie: przybliżaj dwoma palcami.Pobierz raport
„Polski Portret Generatywny” (część I „Polska dla ludzi”, część II „Polska dla biznesu”, strona o narzędziu, aneks metodologiczny)
Zobacz też: Mapa semantyczna Polski →
Jak powstał raport
Badanie obejmuje sześć modeli generatywnej AI, odpytywanych przez ich oficjalne API: ChatGPT, Gemini, Claude, Perplexity, Grok i DeepSeek. Badanie główne trwało od 25 sierpnia do 28 września 2026 roku: modele dostały 1 400 pytań w 11 językach, 700 w imieniu osób prywatnych i 700 w imieniu firm z 12 rynków: Chin, Czech, Francji, Hiszpanii, Niemiec, Norwegii, Słowacji, Szwecji, Ukrainy, USA, Wielkiej Brytanii i Włoch. Pytania dotyczą codziennych decyzji: gdzie pojechać na weekend, gdzie studiować, dokąd się przeprowadzić, gdzie postawić zakład, komu zlecić produkcję, jak sprawdzić kontrahenta. Powstało 8 400 odpowiedzi; każdą ocenił ten sam model-sędzia, a wynik sprawdziło pięć warstw kontroli opisanych w aneksie. Od 30 września do 2 listopada 2026 roku trwały pomiary kontrolne i dodatkowe: krótka lista dla firm (96 pytań bez nazwy Polski, 576 odpowiedzi), pomiary tematyczne o wojnie i pomiar w trybie z wyszukiwaniem. Cały program badawczy to ponad 14 500 odpowiedzi modeli językowych (LLM). Raport ma dwie części: „Polska dla ludzi” i „Polska dla biznesu”.
Dla redakcji
„Polski Portret Generatywny” to mapa semantyczna Polski: zapis tego, jakie miejsca, nazwiska, firmy, argumenty i źródła sześć modeli językowych łączy z naszym krajem, gdy odpowiadają osobom i firmom z 12 krajów. Poniżej najmocniejsze liczby z obu części. Każda ma mianownik i rozdział, w którym jest reszta.
Część I. Polska dla ludzi
Polska jest w odpowiedzi, gdy jest w pytaniu. Gdy pytanie nie wymienia Polski, modele wprowadzają ją same w 72,4% z 1 452 odpowiedzi. W pytaniach o region pada w 91,7%, ale zapytane o Europę „w ogóle” modele wymieniają ją w mniej niż co drugiej odpowiedzi (45,1% z 324). (rozdz. 1–2)
Wymieniana częściej niż polecana. Wyraźne polecenie w 55,9% z 1 051 odpowiedzi, w których model sam wprowadził Polskę; odradza 1,7%. Im rzadziej Polska pada, tym częściej jest polecana: w pytaniach o region 47,0%, w pytaniach o Europę ogólnie 62,3%. (rozdz. 4)
Chopin w każdej odpowiedzi o znanych Polaków, a w jednej na osiem o wyjazd do Polski. 144 ze 144 wobec 12,0% z 1 116 odpowiedzi praktycznych. Polskie gry (Wiedźmin, CD Projekt) są w 86,1% z 72 odpowiedzi na pytanie „z czego Polska dziś słynie” i w 0 z 1 116 odpowiedzi praktycznych. (rozdz. 6)
Ile kosztuje życie w Krakowie? Odpowiedź odsyła do serwisu, którego nikt w Polsce nie redaguje. numbeo.com w 225 z 4 200 odpowiedzi osób prywatnych, GUS w 76. (rozdz. 9)
Sprzedawca wycieczek przed narodowym portalem turystycznym. W źródłach z wyszukiwania getyourguide.com ma 83 cytowania, poland.travel 15. Adresy podane przez model prowadzą w 49,5% do polskich stron, źródła z wyszukiwania w 22,4%. (rozdz. 5)
Zapytane o wojnę, modele nie odradzają Polski, ale prawie zawsze dodają „ale”. 0 z 792 odpowiedzi odradza ją jako kierunek, bez zastrzeżeń 15,7%, NATO w 78,1% (osobny pomiar z października). (podrozdz. 4.7)
14 potwierdzonych błędów faktograficznych (dolna granica, nie częstość); najpoważniejsze dotyczą przepisów, od których zależy decyzja: „Polska nie jest w strefie Schengen”, „Polska nie pozwala na podwójne obywatelstwo”. (rozdz. 7)
Warto się zagłębić: rozdz. 5 (źródła: gov.pl to najczęściej cytowana domena, u każdego z sześciu modeli i na każdym z 12 rynków, a Wikipedia prawie nie istnieje jako źródło, 0,6% cytowań); rozdz. 6 (kanon na zapytanie i kanon w użyciu, czyli luka aktywacji); rozdz. 8 (12 kart rynków: co modele mówią o Polsce osobom z danego kraju).
Część II. Polska dla biznesu
Firmom modele podsuwają Polskę same w 98 odpowiedziach na 100. 98,4% z 576 odpowiedzi na pytania bez nazwy Polski (krótka lista, 30 września); wyraźnie polecona w 82,5%. (rozdz. 2)
Polska przegrywa na geografii, nie na kosztach. Polecenie: rynek zbytu 93,1%, inżynierowie 93,0%, produkcja kontraktowa 69,4%, magazyn dla Europy 62,3%. Koszt jest argumentem Polski w każdej odpowiedzi logistycznej, a hubem są Holandia i Niemcy (dowóz na zachód w 2–3 dni). (rozdz. 2, 4, 10)
KGHM pada w każdej odpowiedzi o największe polskie firmy, a w 21 z 4 200 odpowiedzi dla firm. Polskie firmy, które naprawdę pracują w odpowiedziach dla biznesu, to rejestry: Krajowy Rejestr Długów w 143 odpowiedziach, BIG InfoMonitor w 97. (rozdz. 5)
Proszona o certyfikowanych polskich poddostawców, odpowiedź podaje polską firmę w 5 przypadkach na 30. (rozdz. 5)
PAIH jest w odpowiedziach modeli, a wyszukiwanie w języku rynku rzadko do niej prowadzi. W pytaniach o dotacje PAIH jest w 26 z 27 odpowiedzi z adresami podanymi przez model i w 3 z 12 ze źródłami z wyszukiwania. (rozdz. 6)
Prom przez Bałtyk modele dokładają szwedzkim firmom same. Prom w 87 z 348 odpowiedzi dla szwedzkich firm, choć żadne pytanie nie pyta o prom. (rozdz. 7, 10)
Wojna nie odbiera Polsce polecenia. Żadna z 864 odpowiedzi nie odradza jej jako wyboru, ale tylko 3,8% poleca bez „ale”, a część podsuwa zarządom wrażliwym na ryzyko Czechy. Jako baza odbudowy Ukrainy Polska jest polecona w każdej odpowiedzi. (rozdz. 8)
Dostęp do wyszukiwarki nie wprowadza Polski do odpowiedzi. W osobnym pomiarze z października (233 pytania bez nazwy Polski, trzy modele) wzmianka o Polsce była z wyszukiwaniem taka sama albo rzadsza. (podrozdz. 6.5)
Warto się zagłębić: rozdz. 4 (osiem obszarów decyzji i konkurenci Polski w każdym z nich); rozdz. 6 (źródła dla firm i tryb z wyszukiwaniem); rozdz. 8 (wojna: firmy słyszą o Unii i energii, osoby prywatne o ostrzeżeniach ministerstw).
Dwa cytaty z odpowiedzi modeli
„Polska jest prawdopodobnie najlepszym wyborem dla Skandynawa: stosunkowo blisko, kraj UE, bezpieczna, bogata w przeżycia i znacznie tańsza niż Szwecja, Norwegia czy Dania.”
Claude, Szwecja, pytanie o miasta na weekend „w kraju na wschodzie, który daje dużo za pieniądze”; pytanie bez nazwy Polski. (część I, rozdz. 8)
„Polska jest silnie bronionym sojusznikiem NATO. To w zasadzie jedno z najbezpieczniejszych miejsc w Europie.”
Gemini, USA, pytanie osoby, której rodzice martwią się wyjazdem do Polski; pomiar tematyczny z października. (część II, rozdz. 8)
Cytaty to pojedyncze odpowiedzi, nie oceny modeli. Pełne cytaty z oryginałem i identyfikatorem odpowiedzi są w dokumentach „Kluczowe ustalenia i cytaty”.
Materiały do pobrania
Dla redakcji dostępne są dwa wyciągi (część I i część II), dokumenty „Kluczowe ustalenia i cytaty” dla każdej części oraz 12 notatek lokalnych, po jednej na rynek. Raport ukazuje się po polsku i po angielsku („The Generative Portrait of Poland”).
- Okładka raportu dla mediówJPG · 234,9 kB
- Informacja prasowaPDF · 52,8 kB
- Wyciąg, część IPDF · 42,2 kB
- Wyciąg, część IIPDF · 43,4 kB
- Kluczowe ustalenia i cytaty, część IPDF · 92,3 kB
- Kluczowe ustalenia i cytaty, część IIPDF · 109,3 kB
- 12 notatek lokalnychPDF · 193,6 kB
- Dane otwarte / Open data (ZIP)ZIP · 325,3 kB
Partnerzy raportu
- Partner merytoryczny
 Fundacja AI Business Center · aibusiness.centerFundacja pracuje z firmami przemysłowymi i budowlanymi nad wdrażaniem nowych technologii, efektywnością i przygotowaniem do zmian regulacyjnych.
- Patronat
 Business Centre Club · bcc.org.plKlub przedsiębiorców i organizacja pracodawców. Raport ukazuje się pod patronatem BCC.
Jak cytować
Grzegorz Miłkowski (2026). Polski Portret Generatywny. Brand Semantics P.S.A. https://semantio.pro/pl/reports/generative-portrait-of-poland/
Cytując wyniki lub korzystając z danych, podaj autora, tytuł i link do tej strony.
Czego raport nie mówi
Raport mierzy odpowiedzi modeli zwrócone przez API w datowanym oknie (badanie główne 25 sierpnia – 28 września 2026; pomiary kontrolne i dodatkowe 30 września – 2 listopada 2026), nie to, co widać w aplikacji konsumenckiej, nie ruch na stronach i nie skuteczność żadnej kampanii. Nie prognozuje decyzji inwestycyjnych i nie ocenia pracy żadnej instytucji. Nie układa rankingu rynków ani modeli. Liczb z badania i z krótkiej listy nie łączy, bo to dwa zbiory z osobnymi mianownikami. Aprobaty poszczególnych modeli nie porównuje w tekście głównym, bo cztery z nich miały w badaniu limit długości odpowiedzi (aneks). Jest datowanym stanem, czyli mapą semantyczną Polski w odpowiedziach sześciu modeli na pytania osób i firm z 12 rynków, i tak należy go czytać.
Modele językowe w pigułce
Czym jest model językowy (LLM)?
To program, który nauczył się języka na ogromnej liczbie tekstów i na tej podstawie pisze odpowiedzi zdaniami, jak człowiek. Na takich modelach działają ChatGPT, Claude, Gemini czy Perplexity. Skrót LLM pochodzi od angielskiego „large language model”, czyli duży model językowy.
Czym model językowy różni się od wyszukiwarki?
Wyszukiwarka pokazuje listę stron, a wybór i czytanie zostają po stronie człowieka. Model językowy sam składa gotową odpowiedź, często z rekomendacją. Użytkownik dostaje wniosek, a nie listę źródeł, więc to model decyduje, co w tej odpowiedzi się znajdzie.
Skąd model wie to, co mówi?
Z tekstów, na których się uczył, i coraz częściej z bieżącego wyszukiwania w internecie. Nie sprawdza faktów jak redakcja. Powtarza to, co w tych tekstach pojawiało się często i spójnie. Dlatego może się mylić i dlatego warto mierzyć, co modele naprawdę mówią.
Jak modele językowe mają się do rynku sztucznej inteligencji?
Sztuczna inteligencja to szeroka dziedzina. Modele językowe są jej najbardziej widoczną częścią, bo rozmawiają z ludźmi wprost. Budują je nieliczni dostawcy, a na ich modelach powstają asystenci, wyszukiwarki z odpowiedziami i narzędzia w programach biurowych. Jedna odpowiedź modelu trafia więc do wielu produktów naraz.
Jak zmieniło się szukanie informacji w internecie?
Ludzie coraz częściej zadają pełne pytania, np. „gdzie pojechać na weekend” albo „który dostawca będzie najlepszy”, zamiast wpisywać kilka słów. Odpowiedź dostają od razu, często bez wchodzenia na żadną stronę. Wyszukiwarki też pokazują dziś odpowiedź modelu nad listą wyników.
Co to zmienia dla konsumentów i firm?
Krótka lista z odpowiedzi modelu staje się punktem startu decyzji o podróży, studiach, zakupie czy inwestycji. Miejsce, marka albo kraj, którego model nie wspomni, często w ogóle nie trafia pod rozwagę. Ten raport mierzy, jak w takich odpowiedziach wypada Polska.

O autorze i wydawcy
Autorem raportu jest Grzegorz Miłkowski, założyciel i prezes zarządu Brand Semantics, firmy doradczo-technologicznej zajmującej się semantyką marki i jej pomiarem w modelach językowych. Grzegorz Miłkowski jest także prezesem zarządu Fundacji AI Business Center, partnera merytorycznego raportu. Pomiar wykonano w autorskiej aplikacji badawczej Semantio, która odpytuje modele przez ich oficjalne API i ocenia odpowiedzi tym samym sędzią w datowanym oknie.
Kontakt dla mediów
COO Brand Semantics
Badania na zamówienie i współpraca
Head of Market Education