Хтось збирається зробити покупку, відкриває чат із мовною моделлю та запитує, що обрати. Відповідь надходить готовою: кілька назв, коротке обґрунтування, іноді посилання. Жодного кліку на результат пошуку, жодного відвідування вебсайту бренду, жодного сліду на будь-якій інформаційній панелі. Аналітика нічого не показує, проте рішення щойно було прийнято. Тож де була увага клієнта? У відповіді моделі. І саме модель вирішила, хто її отримав.
Мовна модель як інфлюенсер: п’ять сходинок, які бренд долає, щоб привернути увагу клієнта
Сьогодні мовна модель працює як інфлюенсер, тільки на інших умовах. Вона не має охоплення, яке можна купити, і не підписує контрактів. Вона вирішує, кого показати в момент постановки запитання, і її рекомендація досягає клієнта саме в момент вибору.
У своїй статті про смерть рейтингів я стверджував, що позиція в результатах пошуку перестала бути важливим показником, її замінила ймовірність того, що модель рекомендує бренд. Міхал Гжебик описав у цьому блозі, що означає видимість бренду у відповідях моделі. Обидві статті є сходинками однієї драбини. Тут я піднімаюся ще на одну, тому що ні сама лише присутність, ні сама лише рекомендація не говорять нам, чи має бренд шанс на увагу клієнта.
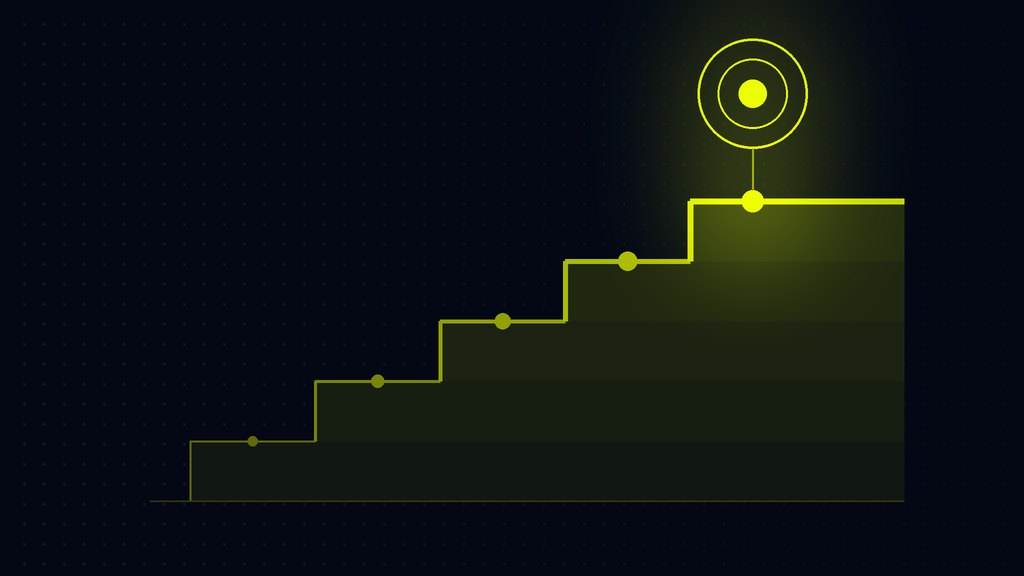
Я розбиваю цей шанс на п’ять сходинок: присутність, конкуренція, позиція, напрямок та передача. Разом вони утворюють сходинки шансу на увагу. Кожна сходинка — це просте запитання, яке маркетолог може поставити про свій бренд, і разом вони описують, що модель пропонує клієнту. Чи справді клієнт це читає — це окреме питання, до якого я повернуся наприкінці.
Звідки беруться цифри в цій статті?
Кожна цифра тут походить з одного нашого власного дослідження. Воно стосується одного конкретного бренду, який я називаю Брендом А, та набору сценаріїв, розроблених для його ситуації: 1400 запитань 11 мовами, поставлених від імені персон з 12 ринків, до шести моделей (ChatGPT, Gemini, Claude, Perplexity, Grok, DeepSeek). Це дало 8400 оцінених відповідей, зібраних між серпнем та жовтнем 2026 року.
Ці відсотки, отже, описують Бренд А, його запитання та версії моделей того періоду. Вони не є ринковою нормою, ані рівнем, за яким слід оцінювати інший бренд. Інша категорія, інші запитання та інші персони дадуть інші цифри. Я показую їх, тому що вони ілюструють механізми, які ми також бачимо при вимірюванні інших брендів: напрямок ефекту схожий, але рівень завжди потрібно вимірювати окремо.
Чому одна відповідь моделі ще нічого не говорить?
Візьмемо одне запитання з дослідження, поставлене мовою одного з ринків, без назви бренду. Шість моделей дали шість різних відповідей. У двох Бренд А взагалі не з’явився. В одній він був четвертим, представлений як «сюрприз». В іншій він отримав окремий розділ, в іншій — єдину згадку в реченні про вартість життя, а в останній він був третім у списку.
Чотири моделі з шести включили бренд у свою відповідь. Це хороший результат? Одне запитання не може сказати. У всій групі подібних запитань модель включила Бренд А у 45,1% з 324 відповідей, тобто менш ніж у кожній другій відповіді. Одна відповідь схожа на один кидок завантаженої кістки: кістка має свої тенденції, але результат одного кидка — це випадковість. Лише фіксований набір запитань, поставлених багато разів, із версією моделі та датою біля кожної цифри, розкриває ці тенденції.
Це дослідження показує ще одну річ. Відмінності між типами запитань були більшими, ніж відмінності між моделями. Те, що запитує клієнт, важить більше, ніж те, яку модель він використовує. Ось чому підготовка дослідження починається з точного опису бренду та ситуацій, у яких клієнти його шукають. Ми розглядаємо це в нашій серії про підготовку дослідження відповідей моделі.
П’ять запитань, які варто поставити про власний бренд
Чи модель сама включає бренд у відповідь?
Перша сходинка — присутність. Коли назва бренду є в запитанні, модель майже завжди говорить про нього: у дослідженні Бренду А — у 99,9% відповідей. Однак це лише відлуння, а не вимірювання. Справжнє випробування починається там, де клієнт не називає бренд, тому що лише там модель сама обирає, кому дати шанс.
У 1452 відповідях на запитання без назви Бренду А модель включила його у 72,4% випадків. Це середнє значення приховує великі відмінності. У запитаннях від приватних осіб (до яких відносяться наступні цифри, якщо я не вказую інше), звужених до сегмента, де конкурує бренд, він з’явився у 91,7% з 552 відповідей. У загальних запитаннях про всю категорію — у 45,1% з 324. У запитаннях, які взагалі не вказували на категорію, — у 20,0% з 90. Присутність, отже, не є властивістю бренду. Це властивість пари: бренду та запитання.
З ким бренд ділиться відповіддю?
Друга сходинка — конкуренція. Модель рідко вказує на один бренд. У 1044 відповідях на запитання без назви Бренду А вона в середньому перерахувала майже шість інших варіантів, і Бренд А був єдиною пропозицією лише у 0,4% випадків. У загальних запитаннях список відкривав лідер, названий у 58,0% відповідей. Бренд А був другим (45,1%), з чотирма варіантами, що йшли слідом, кожен з яких був названий у 38–41% відповідей.
Висновок простий: у відповіді моделі бренд конкурує не з одним суперником, а з цілим списком. Модель, яка складає цей список, вирішує, кого клієнт побачить поруч із вашим брендом.
Наскільки високо бренд стоїть у відповіді?
Третя сходинка — позиція: на початку відповіді або у восьмому абзаці. У прикладі з одним запитанням Бренд А був третім один раз і четвертим один раз. Спокусливо перетворити це на рейтинг. Проте дослідження Бренду А показує, що коли назви бренду немає в запитанні, його позиція змінюється від відповіді до відповіді, навіть коли те саме запитання повторюється в той самий день.
Отже, одна позиція — це не результат. Результат — це те, як часто бренд досягає початку відповіді в рамках фіксованого набору запитань. Коли назва бренду є в запитанні, модель майже завжди починає свою відповідь з неї, але це, знову ж таки, лише відлуння.
Чи модель рекомендує, лише згадує чи радить проти?
Четверта сходинка — напрямок. Коли модель сама включила Бренд А у відповідь, вона чітко рекомендувала його у 55,9% випадків. Вона майже ніколи не радила проти нього (1,7%), але в чотирьох відповідях з десяти вона лише згадувала його, без будь-яких рекомендацій. Міхал Гжебик пояснює різницю між згадкою та рекомендацією в окремій статті.
Найцікавіше те, що тип запитання тут працює навпаки, ніж для присутності. У звужених запитаннях Бренд А з’являється майже завжди, проте його рекомендують лише у 47,0% відповідей. У загальних запитаннях він з’являється рідше, але коли він з’являється, його рекомендують у 62,3%. Присутність за обов’язком — це не те саме, що присутність за вибором. Модель обирає бренд, коли має для цього аргумент, а лічильник згадок не може розрізнити ці дві ситуації.
Куди модель відправляє клієнта?
П’ята сходинка — передача. Це місце, де закінчується канал моделі та починається ваш вебсайт. Адреси, які моделі давали з пам’яті, вели до сторінок, пов’язаних з Брендом А, у 49,5% випадків. Джерела, знайдені через живий пошук, вели туди у 22,4%. Це два різні режими роботи та дві окремі цифри, які я не об’єдную в одну.
Читання відповідей показує, чому. Модель цитує джерело, яке відповідає ситуації запитувача, його мовою та в його контексті. Вона не цитує текст про те, хто такий бренд. Для будь-якого видавця контенту це важливий сигнал: трафік від моделей йде на сторінку, яка відповідає на запитання клієнта.
Шанс на увагу — це знімок
П’ять сходинок описують відповіді з конкретного дня та конкретної версії моделі. У дослідженні Бренду А новіші версії моделей змінили частку чітких рекомендацій більш ніж на десять пунктів за сім тижнів, в обох напрямках і без будь-якої кампанії. Одна модель у своїй новій версії перестала називати бренд у відповіді, де він раніше був у списку. Інша у своїй новій версії помістила його в перше речення.
Такий дрейф змінює значення будь-якого одноразового аудиту. Цифра без версії моделі та дати не має адреси, а вимірювання тримісячної давності лише говорить вам, як було. Шанс на увагу потрібно регулярно перевіряти на одному й тому ж наборі запитань.
Чому відомий бренд ще не є поміченим брендом?
На пряме запитання про найвідоміші назви, пов’язані з Брендом А, моделі давали той самий канон у кожній зі 144 відповідей. У практичних запитаннях той самий канон з’являвся від 12,0% до 0,8% відповідей. Знання потрапляють у відповідь лише через двері, які відкриває запитання клієнта: місце, проблема, конкретна ситуація. У бізнес-запитаннях джерело, яке задовольняло практичну потребу («як перевірити бізнес-партнера?»), з’явилося у 143 з 4200 відповідей, тоді як найбільша компанія в тому ж ландшафті з’явилася у 21.
Отже, модель не рекомендує те, що знає найкраще. Вона рекомендує те, що відповідає запитанню. Ось чому контент бренду має бути побудований навколо ситуацій клієнтів, а не навколо власного опису.
Шанс на увагу — це ще не увага
П’ять сходинок говорять вам, що модель пропонує клієнту. Що клієнт насправді читає та обробляє, показують лише методи, що залучають людей, такі як опитування або відстеження погляду на зразках відповідей. Саме там починається увага, у строгому сенсі. У рекламі частина уваги оцінюється за сигналами даних, такими як час експозиції або прокручування. У відповіді моделі ці сигнали належать виключно платформі, яка її відображає, тому ззовні можна прочитати лише зміст відповіді. Отже, шлях до уваги в каналі ШІ має чотири кроки.
По-перше, запитання без назви бренду: фіксований набір запитань клієнтів, багато запусків, а також версія моделі та дата біля кожного результату. По-друге, п’ять сходинок, прочитані зі змісту відповідей, що є шансом на увагу. По-третє, дослідження за участю людей, яке підтверджує увагу. По-четверте, бізнес-результат: трафік з відповідей, запити, продажі та зростання бренду, пов’язані з кроками два та три.
Поряд з цим маршрутом знаходиться окремий інструмент: аудит якості представлення. Модель 5P, описана в блозі Brand Semantics, перевіряє, чи є відповідь правдивою та чи є результат стабільним. Сходинки шансу на увагу описують шлях бренду до клієнта, тоді як 5P описує якість того, що модель говорить по дорозі.
Що з цього випливає для маркетолога, незалежно від інструменту?
Я зібрав це в п’ять принципів, які діють незалежно від того, чим ви вимірюєте.
- Вимірюйте там, де клієнт не називає бренд. Запитання, що містять назву бренду, є відлунням, а не вимірюванням. Шанс на увагу вирішується запитаннями про категорію, проблему та ситуацію.
- Не рахуйте згадки. Рахуйте згадки з причиною: аргументом, місцем, порівнянням. Згадка без причини займає місце в списку, але не дає клієнту причини для вибору.
- Дайте моделі двері. Факт, число або порівняння, підготовлені для запитання клієнта, потрапляють у відповідь. Текст про те, хто ви є, зазвичай ні.
- Вивчайте запитання аудиторії її мовою та в її контексті. Лише тоді відповідь може направити людей до вас, а не до джерела, яке краще відповідає ситуації клієнта.
- Кожна цифра з версією моделі та датою. Вимірюйте регулярно та рахуйте платну рекламу в чаті окремо від згадки моделі.
Увага стає валютою. У відповіді моделі шанси на її здобуття розподіляються моделлю, і вони дістаються бренду, який дає їй причину.
Якщо ви хочете перевірити ці п’ять сходинок для свого бренду, Semantio ставить моделям запитання без назви бренду та показує, чи включає модель бренд, з ким він стоїть поруч, наскільки сильно його рекомендують і куди модель відправляє людей далі. Ви можете почати з 7-денної пробної версії.
Читайте також: ChatGPT покаже, як часто бренд з’являвся у відповідях. Але не покаже, чому