Noen er i ferd med å kjøpe, åpner en chat med en språkmodell og spør hva de skal velge. Svaret kommer ferdig: noen navn, en kort begrunnelse, noen ganger en lenke. Ingen klikk på et søkeresultat, ingen besøk på merkevarens nettside, ingen spor i noe dashbord. Analysene viser ingenting, likevel er beslutningen nettopp tatt. Så hvor var kundens oppmerksomhet? I modellens svar. Og det var modellen som bestemte hvem som fikk den.
Språkmodellen som influencer: fem trinn en merkevare klatrer for å nå kundens oppmerksomhet
I dag fungerer en språkmodell som en influencer, bare på andre premisser. Den har ingen rekkevidde du kan kjøpe, og den signerer ingen kontrakter. Den bestemmer hvem den skal vise i det øyeblikket spørsmålet stilles, og dens anbefaling når kunden akkurat i valgøyeblikket.
I min artikkel om rangeringenes død argumenterte jeg for at posisjon i søkeresultater hadde sluttet å være det viktigste målet, erstattet av sannsynligheten for at en modell anbefaler merkevaren. Michał Grzebyk beskrev på denne bloggen hva merkevarens synlighet i modellsvar betyr. Begge artiklene er trinn på den samme stigen. Her klatrer jeg ett trinn til, for verken tilstedeværelse alene eller anbefaling alene forteller oss om en merkevare har en sjanse til kundens oppmerksomhet.
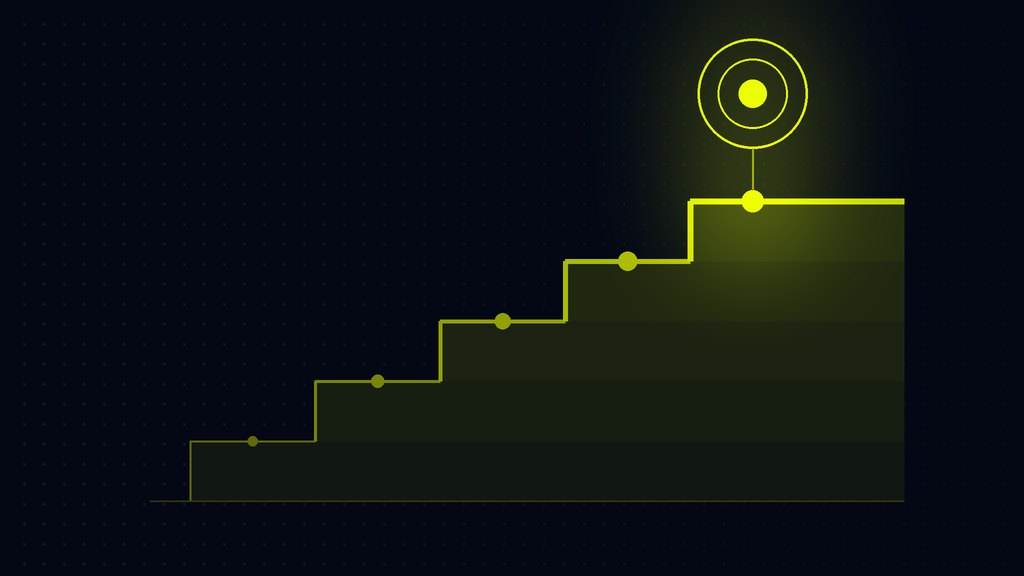
Jeg deler denne sjansen inn i fem trinn: tilstedeværelse, konkurranse, posisjon, retning og overlevering. Sammen danner de stigen for oppmerksomhetssjansen. Hvert trinn er et enkelt spørsmål en markedsfører kan stille om sin egen merkevare, og sammen beskriver de hva modellen presenterer for kunden. Om kunden faktisk leser det, er en separat sak, som jeg kommer tilbake til på slutten.
Hvor kommer tallene i denne artikkelen fra?
Hvert tall her kommer fra en egen studie vi har utført. Den gjelder én spesifikk merkevare, som jeg kaller Merke A, og et sett med scenarier bygget for dens situasjon: 1400 spørsmål på 11 språk, stilt på vegne av personaer fra 12 markeder, til seks modeller (ChatGPT, Gemini, Claude, Perplexity, Grok, DeepSeek). Dette ga 8400 vurderte svar, samlet inn mellom august og oktober 2026.
Disse prosentene beskriver derfor Merke A, dets spørsmål og modellversjonene fra den perioden. De er ikke en markedsnorm, eller et nivå å holde en annen merkevare opp mot. En annen kategori, andre spørsmål og andre personaer vil gi andre tall. Jeg viser dem fordi de illustrerer mekanismer vi også ser når vi måler andre merkevarer: effekten er lik, men nivået må alltid måles separat.
Hvorfor forteller et enkelt modellsvar deg ingenting ennå?
Ta ett spørsmål fra studien, stilt på språket i ett av markedene, uten noe merkenavn. Seks modeller ga seks forskjellige svar. I to dukket Merke A ikke opp i det hele tatt. I ett kom det på fjerdeplass, introdusert som «en overraskelse». I et annet fikk det en egen seksjon, i et annet en enkelt omtale i en setning om levekostnader, og i det siste kom det på tredjeplass på listen.
Fire av seks modeller inkluderte merkevaren i svaret sitt. Er det et godt resultat? Ett spørsmål kan ikke fortelle deg det. I hele gruppen av lignende spørsmål inkluderte modellen Merke A i 45,1 % av 324 svar, altså i færre enn ett av to svar. Et enkelt svar er som ett kast med en lastet terning: terningen har sine tendenser, men utfallet av ett kast er tilfeldig. Bare et fast sett med spørsmål, stilt mange ganger, med modellversjon og dato ved siden av hvert tall, avslører disse tendensene.
Denne studien viser enda en ting. Forskjellene mellom spørsmålstyper var større enn forskjellene mellom modeller. Hva kunden spør om, veier mer enn hvilken modell de bruker. Derfor starter forberedelsen av en studie med en nøyaktig beskrivelse av merkevaren og av situasjonene der kundene leter etter den. Vi dekker dette i vår serie om å forberede en studie av modellsvar.
Fem spørsmål verdt å stille om din egen merkevare
Inkluderer modellen merkevaren i svaret av seg selv?
Det første trinnet er tilstedeværelse. Når merkenavnet er i spørsmålet, snakker modellen om det nesten alltid: i Merke A-studien, i 99,9 % av svarene. Det er imidlertid et ekko, ikke en måling. Den virkelige testen begynner der kunden ikke nevner merkevaren, for bare der velger modellen selv hvem den skal gi en sjanse.
I 1452 svar på spørsmål uten Merke A sitt navn, inkluderte modellen det i 72,4 % av tilfellene. Dette gjennomsnittet skjuler store forskjeller. I spørsmål fra privatpersoner (som de følgende tallene refererer til med mindre jeg sier noe annet) innsnevret til segmentet der merkevaren konkurrerer, dukket det opp i 91,7 % av 552 svar. I generelle spørsmål om hele kategorien, i 45,1 % av 324. I spørsmål som ikke pekte på kategorien i det hele tatt, i 20,0 % av 90. Tilstedeværelse er altså ikke en egenskap ved merkevaren. Det er en egenskap ved et par: merkevaren og spørsmålet.
Hvem deler merkevaren svaret med?
Det andre trinnet er konkurranse. En modell peker sjelden på en enkelt merkevare. I 1044 svar på spørsmål uten Merke A sitt navn, listet den i gjennomsnitt nesten seks andre alternativer, og Merke A var det eneste forslaget i bare 0,4 % av tilfellene. I generelle spørsmål ble listen åpnet av en leder, nevnt i 58,0 % av svarene. Merke A kom på andreplass (45,1 %), med fire alternativer tett bak, hver nevnt i 38–41 % av svarene.
Konklusjonen er enkel: i et modellsvar konkurrerer en merkevare ikke med én rival, men med en hel liste. Modellen som setter sammen den listen, bestemmer hvem kunden vil se ved siden av din merkevare.
Hvor høyt står merkevaren i svaret?
Det tredje trinnet er posisjon: øverst i svaret eller i åttende avsnitt. I eksemplet med ett spørsmål sto Merke A på tredjeplass én gang og fjerdeplass én gang. Det er fristende å gjøre dette om til en rangering. Likevel viser Merke A-studien at når merkenavnet ikke er i spørsmålet, endres posisjonen fra svar til svar, selv når det samme spørsmålet gjentas samme dag.
En enkelt posisjon er altså ikke et resultat. Resultatet er hvor ofte merkevaren når åpningen av svaret på tvers av et fast sett med spørsmål. Når merkenavnet er i spørsmålet, åpner modellen nesten alltid svaret med det, men det er igjen bare et ekko.
Anbefaler modellen, nevner den bare eller fraråder den?
Det fjerde trinnet er retning. Når modellen inkluderte Merke A i svaret av seg selv, anbefalte den det tydelig i 55,9 % av tilfellene. Den frarådet det nesten aldri (1,7 %), men i fire av ti svar nevnte den det bare, uten noen anbefaling i det hele tatt. Michał Grzebyk forklarer forskjellen mellom en omtale og en anbefaling i en egen artikkel.
Det mest interessante er at spørsmålstypen fungerer motsatt her enn for tilstedeværelse. I innsnevrede spørsmål dukker Merke A opp nesten alltid, men det anbefales i bare 47,0 % av svarene. I generelle spørsmål dukker det opp sjeldnere, men når det dukker opp, anbefales det i 62,3 %. Tilstedeværelse av plikt er ikke det samme som tilstedeværelse av valg. Modellen velger en merkevare når den har et argument for det, og en omtaleteller kan ikke skille de to situasjonene fra hverandre.
Hvor sender modellen kunden?
Det femte trinnet er overlevering. Dette er der modellens kanal slutter og din nettside begynner. Adresser som modeller ga fra minnet, førte til sider knyttet til Merke A i 49,5 % av tilfellene. Kilder funnet gjennom live søk førte dit i 22,4 %. Dette er to forskjellige arbeidsmåter og to separate tall, som jeg ikke kombinerer til ett.
Å lese svarene viser hvorfor. Modellen siterer en kilde som adresserer spørgerens situasjon, på deres språk og kontekst. Den siterer ikke en tekst om hvem merkevaren er. For enhver innholdsutgiver er det et viktig signal: trafikk fra modeller går til siden som svarer på kundens spørsmål.
Sjansen for oppmerksomhet er et øyeblikksbilde
De fem trinnene beskriver svar fra en spesifikk dag og en spesifikk modellversjon. I Merke A-studien flyttet nyere modellversjoner andelen klare anbefalinger med mer enn ti poeng på syv uker, i begge retninger og uten noen kampanje. Én modell, i sin nye versjon, sluttet å nevne merkevaren i et svar der den tidligere hadde vært på listen. En annen, i sin nye versjon, plasserte den i første setning.
Slik drift endrer betydningen av enhver engangsrevisjon. Et tall uten modellversjon og dato har ingen adresse, og en måling fra et kvartal siden forteller deg bare hvordan ting var. Sjansen for oppmerksomhet må sjekkes regelmessig, på det samme settet med spørsmål.
Hvorfor er en kjent merkevare ennå ikke en sett merkevare?
Spurt direkte om de mest kjente navnene assosiert med Merke A, ga modellene den samme kanonen i hvert av 144 svar. I praktiske spørsmål dukket den samme kanonen opp i mellom 12,0 % og 0,8 % av svarene. Kunnskap kommer inn i et svar bare gjennom en dør som kundens spørsmål åpner: et sted, et problem, en spesifikk situasjon. I forretningsspørsmål dukket kilden som møtte et praktisk behov ("hvordan sjekker jeg en forretningspartner?") opp i 143 av 4200 svar, mens det største selskapet i samme landskap dukket opp i 21.
Så modellen anbefaler ikke det den kjenner best. Den anbefaler det som passer spørsmålet. Derfor må en merkevares innhold bygges rundt kundenes situasjoner, ikke rundt dens egen beskrivelse.
En sjanse for oppmerksomhet er ennå ikke oppmerksomhet
De fem trinnene forteller deg hva modellen presenterer for kunden. Hva kunden faktisk leser og behandler, vises bare av metoder som involverer mennesker, for eksempel en undersøkelse eller øyesporing på utvalg av svar. Det er der oppmerksomhet, i streng forstand, begynner. I reklame estimeres en del av oppmerksomheten fra datasignaler som eksponeringstid eller rulling. I et modellsvar tilhører disse signalene utelukkende plattformen som viser det, så utenfra kan bare innholdet i svaret leses. Veien til oppmerksomhet i AI-kanalen har derfor fire trinn.
Først, spørsmål uten merkenavnet: et fast sett med kundespørsmål, mange kjøringer, og modellversjon og dato ved siden av hvert resultat. For det andre, de fem trinnene lest fra innholdet i svarene, som er sjansen for oppmerksomhet. For det tredje, forskning som involverer mennesker, som bekrefter oppmerksomhet. For det fjerde, forretningsresultatet: trafikk fra svar, henvendelser, salg og merkevareløft, knyttet til trinn to og tre.
Ved siden av denne ruten sitter et separat verktøy: en revisjon av representasjonskvalitet. 5P-modellen, beskrevet på Brand Semantics-bloggen, sjekker om et svar er sant og om resultatet er stabilt. Stigen for oppmerksomhetssjansen beskriver merkevarens vei til kunden, mens 5P beskriver kvaliteten på det modellen sier underveis.
Hva følger for en markedsfører, uansett verktøy?
Jeg har samlet det i fem prinsipper som gjelder uansett hva du måler med.
- Mål der kunden ikke nevner merkevaren. Spørsmål som inkluderer merkenavnet er et ekko, ikke en måling. Sjansen for oppmerksomhet avgjøres av spørsmål om kategori, problem og situasjon.
- Ikke tell omtaler. Tell omtaler med en grunn: et argument, et sted, en sammenligning. En omtale uten grunn tar en plass på listen, men gir kunden ingen grunn til å velge.
- Gi modellen en dør. Et faktum, et tall eller en sammenligning forberedt for kundens spørsmål kommer inn i svaret. En tekst om hvem du er, gjør det vanligvis ikke.
- Studer publikums spørsmål på deres språk og kontekst. Først da kan svaret sende folk til deg, snarere enn til en kilde som passer kundens situasjon bedre.
- Hvert tall med modellversjon og dato. Mål regelmessig, og tell betalt annonsering i chatten separat fra modellens omtale.
Oppmerksomhet er i ferd med å bli en valuta. I et modellsvar deles sjansene for å vinne den ut av modellen, og de går til merkevaren som gir den en grunn.
Hvis du vil sjekke disse fem trinnene for din egen merkevare, stiller Semantio modeller spørsmål uten merkenavnet og viser om modellen inkluderer merkevaren, hvem den er satt sammen med, hvor sterkt den anbefales og hvor modellen sender folk videre. Du kan starte med en 7-dagers prøveperiode.
Les også: ChatGPT vil vise hvor ofte et merke dukket opp i svar. Det vil ikke vise hvorfor