Del I | Forskningsgrunnlag og merkevareinformasjon
Du kan samle hundrevis av svar fra ChatGPT, Gemini, Perplexity og andre systemer og likevel ikke lære noe pålitelig om merkevaren din. Alt som skal til er at forskningsobjektet er beskrevet for bredt, unøyaktig eller i posisjoneringsspråk. Derfor er den første seriøse beslutningen i Semantio ikke å velge en modell eller skrive et scenario. Det er å definere hva, nøyaktig, som skal forskes på.
Forskning på en merkevares synlighet i generativ kunstig intelligens kan virke som en prosess som starter med et spørsmål. Vi velger et system, kjører scenarier, samler inn svar og observerer om merkevaren er nevnt, beskrevet eller anbefalt.
Metodologisk sett begynner imidlertid prosessen mye tidligere.
Før vi sjekker hva modellene sier om en merkevare, må vi etablere hva som teller som den merkevaren innenfor grensene av en bestemt studie. Vi må identifisere dens offisielle navn og aliaser, definere markedet, skille den fra eieren, konsernet, distributøren eller partneren, og beskrive dens faktiske aktivitetsomfang. Bare på dette grunnlaget kan vi bygge scenarier og tolke resultater.
I Semantio leveres dette grunnlaget av Identiteten. Det er ikke en firmaprofil eller en forkortet versjon av en Om oss-side. Det er en modell av enheten som forskes på, som påfølgende stadier av overvåking av merkevarerepresentasjon i generativ AI bygges på.
Identitet er ikke merkevarens selvpresentasjon
En beskrivelse utarbeidet for forskning tjener et annet formål enn salgstekst.
En nettside kan hevde at et selskap er innovativt, fleksibelt, engasjert og nær kundene sine. En strategisk presentasjon kan definere ambisjoner, ønskede assosiasjoner og konkurransefortrinn. Salgsmateriell kan ramme inn konkurrenter gjennom kommersielle argumenter.
Ingen av disse materialene er automatisk en nøytral beskrivelse av forskningsobjektet.
Identitet bør svare på enklere, men mer krevende spørsmål:
hvilken merkevare, selskap eller institusjon forskes det på?
i hvilket marked og språk?
hvilke produkter, tjenester eller løsninger tilbyr den faktisk?
hvilke navn refererer til samme enhet?
hvilke enheter er relatert til den, men forblir separate?
hvilke grenser for tilbudet eller geografisk rekkevidde må opprettholdes?
hvilke opplysninger er fakta, og hvilke er bare merkevarepåstander?
Dette skillet er avgjørende. Identitet beskriver hva vi ønsker å undersøke, ikke hva vi ønsker at forskningen skal bevise.
Hvis vi fra starten skriver at en merkevare er den beste, mest pålitelige eller mest innovative leverandøren i sin kategori, forbereder vi ikke et nøytralt referansepunkt. Vi introduserer et forventet resultat i prosjektet.
En feil i beskrivelsen kan bli en feil i hele studien
Et unøyaktig skjema kan se ut som en liten ufullkommenhet. I praksis kan det endre konstruksjonen av hvert senere stadium. Det kan villede store språkmodeller først, og deretter forvrenge tolkningen av de innsamlede dataene.
For eksempel, hvis en lokal forhandler og installatør er en autorisert partner av en global produsent, betyr dette ikke at det lokale selskapet tilbyr alle produsentens produkter, teknologier og kapasiteter i alle markeder. Hvis et utdanningsmerke bruker en metode skapt av en annen person eller organisasjon, må disse enhetene ikke automatisk behandles som identiske i alle henseender. Hvis et polsk selskap tilhører en internasjonal gruppe, blir gruppens tilbud ikke automatisk det polske selskapets tilbud.
Konsekvensene av slike forenklinger kommer tilbake senere:
scenarier kan gjelde produkter som den undersøkte merkevaren ikke tilbyr
modeller kan vurderes mot et feil sett med fakta
et svar som gjelder en annen enhet kan behandles som korrekt
en ekte hallusinasjon kan forbli uoppdaget
konkurrenter kan velges fra feil kategori
resultatet kan virke presist mens det måler et annet objekt enn det som var tiltenkt
Derfor definerer en praktisk AI-synlighetsrevisjon først en referansemodell, og vurderer deretter tilstedeværelsen, rollen, nøyaktigheten, bevisene og stabiliteten til svarene.
Human-in-the-loop starter før forskningen
Menneskets rolle er ikke begrenset til å sjekke tekst utarbeidet av et AI-støttet system.
Et verktøy kan finne enhetsnavn, trekke ut produktlister, organisere dokumenter, foreslå målgrupper og identifisere selskaper fra en lignende kategori. Noen må fortsatt bestemme:
hvor grensen for den undersøkte merkevaren ligger
hvilket marked prosjektet dekker
hva er et produkt, hva er en tjeneste og hva er bare en variant
hvilken informasjon er aktuell
hvilke kapasiteter tilhører merkevaren og hvilke tilhører en partner eller gruppe
hvilket detaljnivå er nødvendig
hva som ennå ikke er bekreftet
Disse beslutningene krever kunnskap om merkevaren og hvordan den faktisk opererer. De krever ofte den samlede kunnskapen fra flere personer: merkevareeieren, produktsjefen, salgsteamet, kundeserviceteamet, det tekniske teamet eller personen som utfører forskningen.
En merkevareekspert er heller ikke en ufeilbarlig kilde. Deres kunnskap hjelper til med å forstå kontekst, identifisere hull og løse grenser. Det fjerner ikke behovet for å verifisere fakta eller skille erfaring fra antagelser.
Det beste resultatet oppstår når en person forblir i loopen på tre nivåer:
definerer forskningsobjektet
verifiserer informasjon mot kilder og organisatorisk kunnskap
godkjenner den endelige modellen før den brukes til å generere scenarier og vurdere svar
To måter å starte på
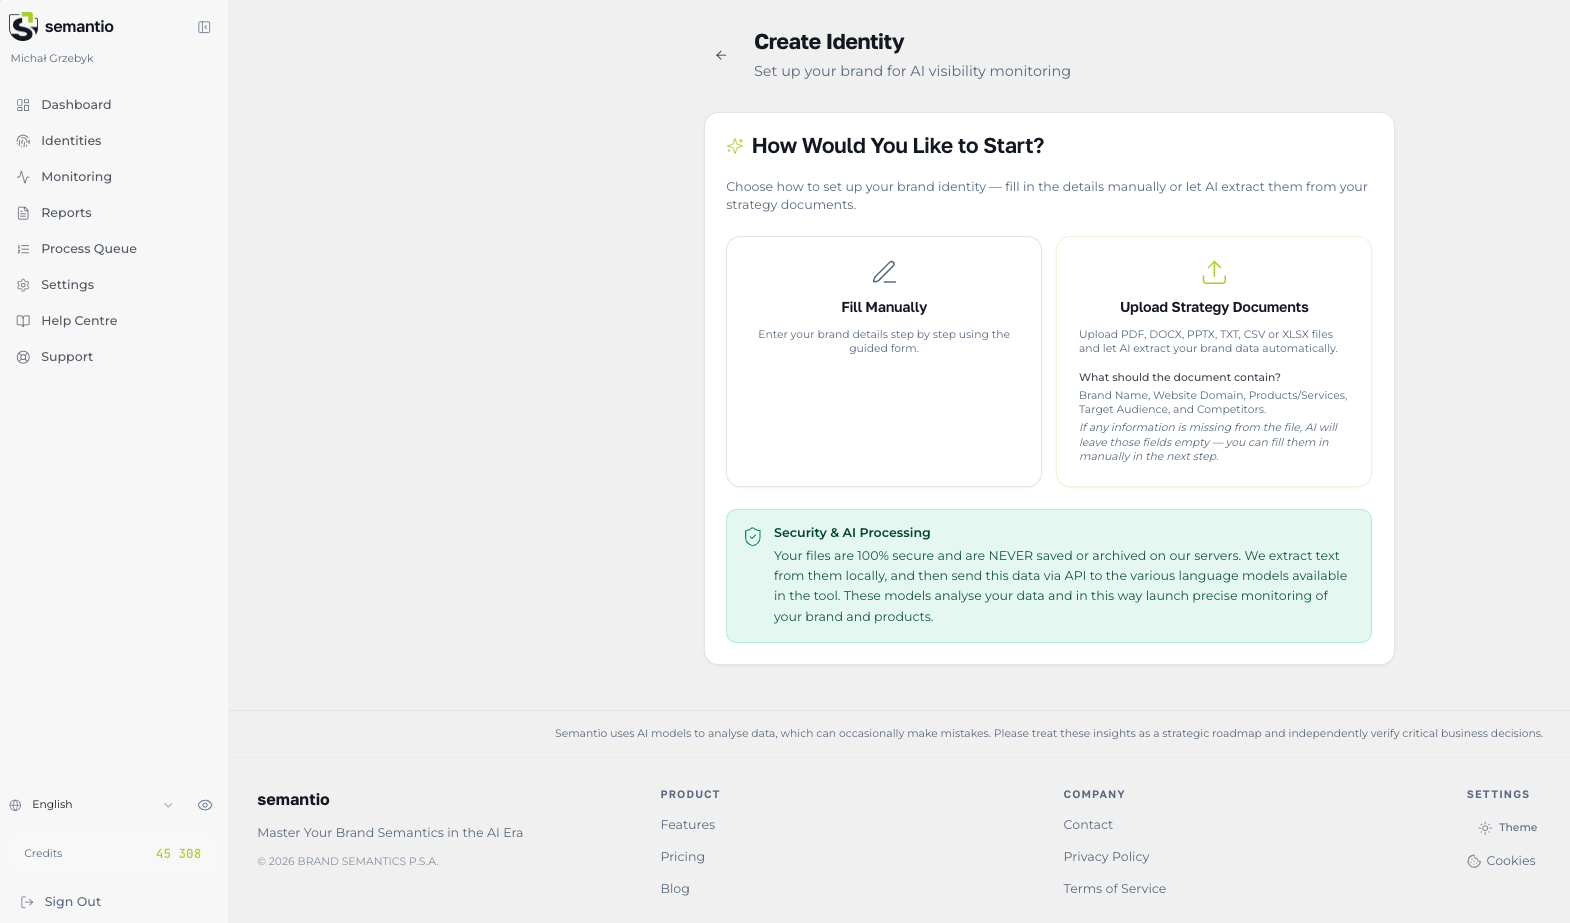
I den nåværende versjonen av Semantio kan du begynne å opprette en identitet på to måter.
Fyll ut manuelt
Den manuelle ruten går gjennom suksessive seksjoner av skjemaet. Brukeren legger inn informasjon om merkevaren, produkter, personaer og konkurrenter uavhengig.
Dette er den anbefalte tilnærmingen, spesielt når:
merkevaren har en kompleks struktur
tilbudet varierer mellom markeder
strategiske dokumenter inneholder mye posisjoneringsspråk
selskapet opererer i både B2B og B2C
deler av tilbudet kommer fra eksterne partnere eller produsenter
forskningen dekker bare deler av porteføljen
du trenger tett kontroll over hvert element
Manuell inntasting er ikke verdifull fordi det tar lengre tid. Det er verdifullt fordi det krever en rekke bevisste beslutninger. Hvert navn, grense, kategori og forhold må vurderes separat.
Last opp strategidokumenter
Den andre ruten lar deg laste opp materialer i formater angitt i grensesnittet, inkludert PDF, DOCX, PPTX, TXT, CSV og XLSX. Semantio kan bruke dem til å trekke ut informasjon om merkevaren, domenet, produktene, målgruppene og konkurrentene. Hvis et dokument ikke inneholder den nødvendige informasjonen, kan det relevante feltet forbli tomt for senere utfylling.
Dette er en nyttig akselerasjon, men ikke en frittstående metode for å forstå en merkevare. Hvorfor? En generativ modell kan ikke etablere en korrekt identitet uten egnet innmatingsmateriale. Dessuten avhenger kvaliteten på resultatet av kvaliteten, aktualiteten og omfanget av de opplastede dokumentene. Hvis en strategisk presentasjon inneholder ambisiøs posisjonering, brede verdier og sammenligninger med konkurrenter, kan automatisert utvinning trofast overføre nettopp det innholdet som senere vil undergrave forskningens nøytralitet.
Av denne grunn bør en beskrivelse generert fra dokumenter behandles som et utkast. Hvert felt krever gjennomgang av noen som vet:
hvilket marked materialet gjelder
om dokumentet beskriver den nåværende tilstanden til virksomheten
om det presenterer hele selskapet, en bestemt merkevare eller bare en produktlinje
hvilke utsagn som er fakta
hvilke utsagn som uttrykker ambisjon eller posisjonering
hva dokumentet ikke inneholder i det hele tatt
Automatisert utvinning kan fremskynde arbeidet. Det overfører ikke ansvaret for omfanget og nøytraliteten av beskrivelsen fra en person til en modell.
Forbered materialet før du begynner å fylle ut felter
Det beste utgangspunktet er ikke en enkelt nettside, men et lite, organisert sett med kilder.
Det er verdt å forberede:
den offisielle merkevarens nettside og hoveddomene
aktuelle produkt- og tjenestesider
kataloger, dokumentasjon, vilkår og betingelser, prislister eller teknisk materiale
informasjon om eierstruktur og relaterte enheter
offisielle merkevareprofiler, hvis de bidrar til å bekrefte det nåværende aktivitetsomfanget
kunnskap hos personer som er ansvarlige for produkt, salg og kunder
en liste over alternative navn, forkortelser og historiske varianter som fortsatt er i omløp
en liste over viktige hull og omstridte spørsmål
Hierarkiet er viktig. Materialer levert av merkevaren og offisielle kilder bør prioriteres. Pålitelige eksterne kilder kan bekrefte spesifikke fakta, men de bør ikke brukes til å fylle ut informasjon bare fordi det høres plausibelt ut.
Du bør heller ikke bygge beskrivelsen utelukkende fra søkeresultatsnutter. De er tatt ut av kontekst, kan være utdaterte og viser ikke hvilken enhet informasjonen refererer til.
Hvis en organisasjon ennå ikke har sammenhengende materialer, kan problemet gå utover bare å fylle ut et skjema. I så fall kan utgangspunktet være å organisere definisjoner, relasjoner og språk som en del av merkevarens semantiske strategi.
Etabler forskningsomfanget først
Den første arbeidssetningen bør være:
I denne forskningen analyserer vi nøyaktig...
Fyll deretter ut slik at det ikke er rom for flere like gyldige tolkninger.
Omfanget bør definere:
den undersøkte merkevaren, selskapet eller institusjonen
landet eller regionen
språket
B2B, B2C eller hybridmodellen
hele tilbudet eller en spesifisert del av porteføljen
eventuelle geografiske og organisatoriske grenser
viktige ekskluderinger
Eksempel:
I denne forskningen analyserer vi en polsk merkevare som tilbyr rådgivning, installasjon og service for porter og dører i hjemmemarkedet. Vi tilskriver den ikke hele tilbudet fra den internasjonale produsenten den er en autorisert partner av.
Denne setningen skiller umiddelbart to enheter og forhindrer at tilbudet utvides gjennom assosiasjon.
Et annet eksempel:
I denne forskningen analyserer vi et utdanningsmerke som driver kurs og arrangementer relatert til en spesifikk utviklingsmetode. Vi skiller mellom merkevaren, skaperen av metoden, den internasjonale organisasjonen og de juridiske enhetene som leverer tjenestene.
Uten dette skillet kan en modell oppgi fakta korrekt om metoden eller dens skaper, men likevel ikke svare på spørsmålet om den undersøkte merkevaren.
Skill enheter før du begynner å beskrive dem
Et selskap kan fremstå samtidig som et handelsmerke, juridisk enhet, lokal filial, distributør, autorisert partner, medlem av en gruppe eller programoperatør. Disse rollene er ikke utskiftbare.
Før du fyller ut beskrivelsen, er det verdt å forberede en enkel arbeidstabell:
enhet | forhold til merkevaren | er det en del av forskningsobjektet? |
|---|---|---|
handelsmerke | hovedundersøkt enhet | ja |
operativt selskap | eier eller operatør av merkevaren | avhenger av omfanget |
internasjonal gruppe | eier eller organisatorisk kontekst | vanligvis kun kontekst |
ekstern produsent | produktleverandør | nei, hvis det forblir et separat merke |
teknologipartner | leverer utvalgte løsninger | nei |
søstermerke | tilhører samme gruppe | nei, med mindre inkludert i forskningen |
Formålet er ikke å utvide profilen med hele selskapshistorien. Det er å unngå feil som senere kan påvirke vurderingen av modellsvarene.
Hvordan fylle ut merkevareinformasjon
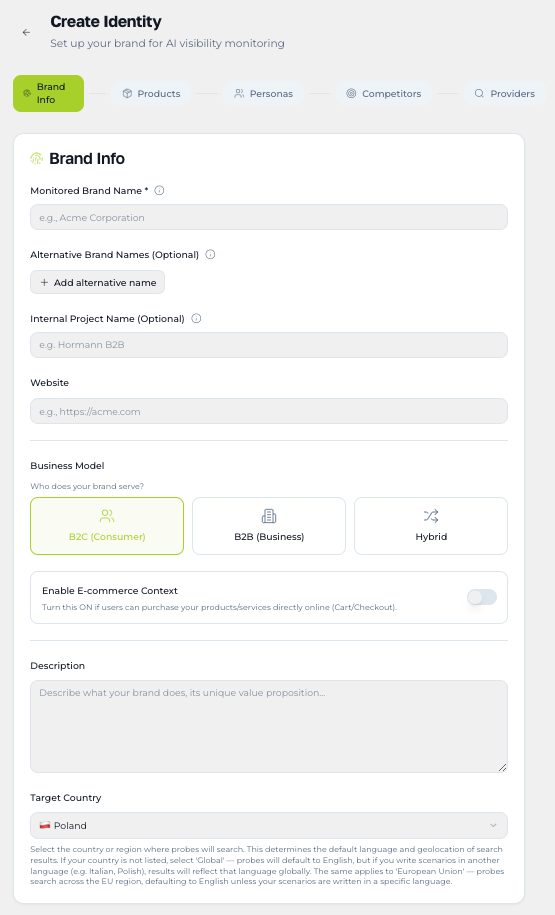
Seksjonen Merkevareinformasjon samler kjerneinformasjon om enheten som forskes på. Hvert felt har en annen funksjon.
Husk at valg av land ikke er en teknisk formalitet. Den samme merkevaren kan ha et annet tilbud, forskjellige konkurrenter og forskjellige kjøpssituasjoner i Norge, Tyskland eller det globale markedet. Hvis det geografiske omfanget forblir uklart, kan senere svar være korrekte for et annet marked enn det som er viktig for organisasjonen.
felt | hva skal du skrive inn? | hva skal du passe på? |
|---|---|---|
Overvåket merkevarenavn | Det offisielle, nåværende navnet på den undersøkte merkevaren. | Ikke skriv inn både merkevaren og hele gruppen hvis de er separate enheter. |
Alternative merkevarenavn | Ekte stavevarianter, forkortelser og navn brukt for samme enhet. | Ikke legg til partnere, søstermerker eller eieren som aliaser. |
Internt prosjektnavn | Et navn som hjelper teamet med å gjenkjenne prosjektet, spesielt når du administrerer flere prosjekter. | Dette er en organisatorisk merkelapp, ikke merkevarens offentlige navn. |
Nettsted | Det offisielle hoveddomenet til den undersøkte enheten. | Ikke oppgi domenet til en gruppe, partner eller ekstern katalog i stedet for merkevarens nettsted. |
Forretningsmodell | B2C, B2B eller Hybrid, i henhold til det faktiske aktivitetsomfanget. | Ikke velg modellen basert på et enkelt produkt. |
Aktiver e-handelskontekst | Aktiver det hvis en bruker faktisk kan kjøpe et produkt eller en tjeneste på nettet. | Et kontaktskjema og produktkatalog betyr ikke i seg selv e-handel. |
Beskrivelse | En kort, nøytral og faktabasert beskrivelse. | Fjern påstander, ambisjoner, superlativer og posisjonering mot konkurrenter. |
Målland | Markedet der forskningen skal utføres. | Landet påvirker den språklige og geografiske konteksten av resultatene. |
Start med en definisjon, ikke en måling
Hvis du vil sjekke hvordan AI-modeller representerer merkevaren din, forbered først kildene og involver noen som kjenner tilbudet og organisasjonsstrukturen. Deretter oppretter du en ny identitet i Semantio og gir Brand Info-seksjonen like mye oppmerksomhet som du ville gitt til forutsetningene for hele studien.
For det er akkurat det det er.
Semantio kan senere overvåke svar fra flere systemer konsekvent og vise endringer i merkevarerepresentasjon. Ingen måling kan imidlertid korrigere et tvetydig forskningsobjekt. Først må du bygge et referansepunkt du kan stole på.
I del II går vi videre til å lage en nøytral merkevarebeskrivelse og organisere tilbudet.