Ktoś planuje zakup, otwiera czat z modelem językowym i pyta, co wybrać. Dostaje gotową odpowiedź: kilka nazw, krótkie uzasadnienie, czasem link. Nie klika w wyniki wyszukiwania, nie wchodzi na stronę marki i nie zostawia śladu w żadnym panelu. W analityce jest pustka, a decyzja właśnie zapadła. Gdzie w takim razie była uwaga klienta? W odpowiedzi modelu. I to model zdecydował, kto ją dostał.
Model językowy jako influencer: pięć szczebli, po których marka dochodzi do uwagi klienta
Model językowy działa dziś jak influencer, tylko z innego tytułu. Nie ma zasięgów, które można kupić, i nie podpisuje umów. O tym, kogo pokaże, decyduje w chwili pytania, a jego rekomendacja trafia do klienta dokładnie wtedy, gdy ten wybiera.
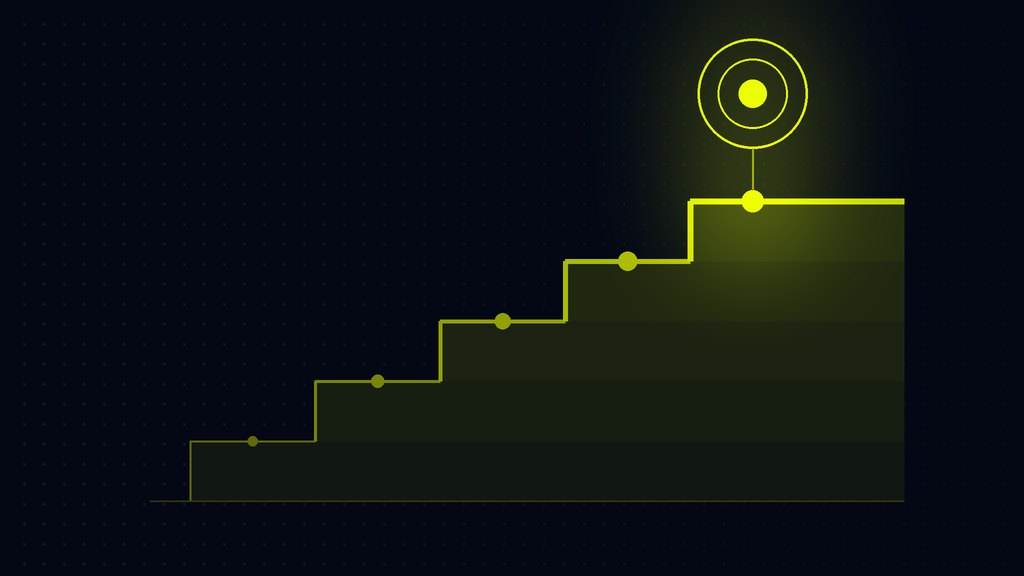
W tekście o końcu ery rankingów pisałem, że miejsce w wynikach wyszukiwania przestało być miarą, a zastąpiło je prawdopodobieństwo, że model poleci markę. Michał Grzebyk opisał na tym blogu, czym jest widoczność marki w odpowiedziach modeli. Oba teksty to szczeble tej samej drabiny. Dziś wchodzę na kolejny, bo ani sama obecność, ani sama rekomendacja nie mówią jeszcze, czy marka ma szansę na uwagę klienta.
Szansę na uwagę rozkładam na pięć szczebli: obecność, konkurencję, miejsce, kierunek i przekazanie. Każdy z nich to proste pytanie, które marketer może zadać o własną markę. Razem opisują to, co model stawia przed oczami klienta. Czy klient tę treść naprawdę przeczyta, to już osobna sprawa, do której wrócę na końcu.
Skąd pochodzą liczby w tym tekście?
Wszystkie liczby, które tu podaję, pochodzą z jednego badania własnego. Dotyczą jednej konkretnej marki, którą nazywam tu marką A, i zestawu scenariuszy przygotowanych dla jej sytuacji: 1 400 pytań w 11 językach, zadanych w imieniu person z 12 rynków sześciu modelom (ChatGPT, Gemini, Claude, Perplexity, Grok, DeepSeek). Dało to 8 400 ocenionych odpowiedzi, a pomiar wykonano między sierpniem a październikiem 2026 roku.
Te procenty opisują więc markę A, jej pytania i wersje modeli z tamtego okresu. Nie są normą rynkową ani poziomem, do którego warto przykładać inną markę. Inna kategoria, inne pytania i inne persony dadzą inne liczby. Pokazuję je, bo dobrze ilustrują mechanizmy, które widzimy także w pomiarach innych marek: kierunek zjawiska jest podobny, poziom zawsze trzeba zmierzyć osobno.
Dlaczego jedna odpowiedź modelu nic jeszcze nie mówi?
Weźmy jedno pytanie z tego badania, zadane w języku jednego z rynków, bez nazwy żadnej marki. Sześć modeli dało sześć różnych odpowiedzi. W dwóch marki A nie było wcale. W jednej pojawiła się na czwartym miejscu, przedstawiona jako „niespodzianka”. W innej dostała osobną sekcję, w jeszcze innej jedną wzmiankę w zdaniu o kosztach, a w ostatniej trzecie miejsce na liście.
Cztery modele z sześciu wprowadziły markę do odpowiedzi. Czy to dobry wynik? Tego jedno pytanie nie powie. W całej grupie podobnych pytań model wprowadzał markę A w 45,1% z 324 odpowiedzi, czyli w mniej niż co drugiej. Pojedyncza odpowiedź przypomina rzut obciążoną kostką: kostka ma swoje skłonności, ale wynik jednego rzutu jest przypadkiem. O skłonnościach mówi dopiero stały zestaw pytań, zadawany wiele razy, z wersją i datą modelu przy każdej liczbie.
W tym badaniu widać jeszcze jedno. Różnice między typami pytań były większe niż różnice między modelami. To, o co pyta klient, waży więcej niż to, którego modelu używa. Dlatego przygotowanie badania zaczyna się od rzetelnego opisu marki i sytuacji, w których klienci jej szukają. Piszemy o tym w serii o przygotowaniu badania odpowiedzi modeli.
Pięć pytań, które warto zadać o własną markę
Czy model sam wprowadza markę do odpowiedzi?
Pierwszy szczebel to obecność. Gdy nazwa marki pada w pytaniu, model mówi o niej prawie zawsze: w badaniu marki A w 99,9% odpowiedzi. To jednak echo, a nie pomiar. Prawdziwy test zaczyna się tam, gdzie klient marki nie wymienia, bo tylko tam model sam wybiera, komu dać szansę.
W 1 452 odpowiedziach na pytania bez nazwy marki A model wprowadzał ją w 72,4%. Ta średnia ukrywa jednak duże różnice. W pytaniach osób prywatnych (od tego miejsca o nich mowa, jeżeli nie piszę inaczej) zawężonych do segmentu, w którym marka gra, pojawiała się w 91,7% z 552 odpowiedzi. W pytaniach ogólnych o całą kategorię w 45,1% z 324. W pytaniach, które kategorii nie wskazywały wcale, w 20,0% z 90. Obecność nie jest więc cechą marki. Jest cechą pary: marka i pytanie.
Z kim marka dzieli odpowiedź?
Drugi szczebel to konkurencja. Model rzadko wskazuje jedną markę. W 1 044 odpowiedziach na pytania bez nazwy marki A wymieniał średnio prawie sześć innych opcji, a marka A była jedyną propozycją tylko w 0,4% przypadków. W pytaniach ogólnych listę otwierał lider, wymieniany w 58,0% odpowiedzi. Marka A była druga (45,1%), a tuż za nią stały cztery opcje wymieniane w 38–41% odpowiedzi.
Wniosek jest prosty: w odpowiedzi modelu marka konkuruje nie z jednym rywalem, ale z całą listą. Model, który tę listę układa, decyduje, obok kogo klient zobaczy Twoją markę.
Jak wysoko stoi marka w odpowiedzi?
Trzeci szczebel to miejsce: na górze odpowiedzi czy w ósmym akapicie. W przykładzie z jednym pytaniem marka A stała raz na trzecim, raz na czwartym miejscu. Kusi, żeby z tego zrobić ranking. W badaniu marki A widać jednak, że gdy nazwy marki nie ma w pytaniu, jej miejsce zmienia się z odpowiedzi na odpowiedź, także przy powtórzeniu tego samego pytania tego samego dnia.
Pojedyncza pozycja nie jest więc wynikiem. Wynikiem jest to, jak często marka trafia do początku odpowiedzi w stałym zestawie pytań. Gdy nazwa marki pada w pytaniu, model otwiera nią odpowiedź prawie zawsze, ale to znowu tylko echo.
Czy model poleca, tylko wymienia czy odradza?
Czwarty szczebel to kierunek. Gdy model sam wprowadzał markę A do odpowiedzi, w 55,9% przypadków wyraźnie ją polecał. Prawie nigdy jej nie odradzał (1,7%), ale w czterech odpowiedziach na dziesięć tylko ją wymieniał, bez żadnej rekomendacji. Różnicę między wzmianką a rekomendacją Michał Grzebyk opisał w osobnym tekście.
Najciekawsze jest to, że typ pytania działa tu odwrotnie niż przy obecności. W pytaniach zawężonych marka A pada prawie zawsze, jednak polecenie dostaje tylko w 47,0% odpowiedzi. W pytaniach ogólnych pada rzadziej, ale jeżeli już się pojawia, jest polecana w 62,3%. Obecność z obowiązku to coś innego niż obecność z wyboru. Model wybiera markę wtedy, gdy ma dla niej argument, a licznik wzmianek tych dwóch sytuacji nie odróżnia.
Dokąd model odsyła klienta?
Piąty szczebel to przekazanie. Tu kończy się kanał modelu, a zaczyna Twój serwis. Adresy, które modele podawały z pamięci, prowadziły do stron związanych z marką A w 49,5% przypadków. Źródła znalezione w wyszukiwaniu na żywo prowadziły tam w 22,4%. To dwa różne tryby pracy i dwie osobne liczby, których nie łączę w jedną.
Lektura odpowiedzi pokazuje, dlaczego tak się dzieje. Model cytuje źródło, które odpowiada na sytuację osoby pytającej, w jej języku i kontekście. Nie cytuje tekstu o tym, kim jest marka. Dla każdego wydawcy treści to istotna wskazówka: ruch z modeli dostaje strona, która odpowiada na pytanie klienta.
Szansa na uwagę jest stanem na dziś
Pięć szczebli opisuje odpowiedzi z konkretnego dnia i konkretnej wersji modelu. W badaniu marki A nowsze wersje modeli przesunęły odsetek wyraźnych poleceń marki A o kilkanaście punktów w siedem tygodni, w obie strony i bez żadnej kampanii. Jeden model w nowej wersji przestał wymieniać markę w odpowiedzi, w której wcześniej była na liście. Inny w nowej wersji postawił ją w pierwszym zdaniu.
Taki dryf zmienia sens każdego jednorazowego audytu. Liczba bez wersji i daty modelu nie ma adresu, a pomiar sprzed kwartału mówi tylko, jak było. Szansę na uwagę trzeba sprawdzać cyklicznie, na tym samym zestawie pytań.
Dlaczego marka znana to jeszcze nie marka zobaczona?
Zapytane wprost o najbardziej znane nazwiska związane z marką A, modele podawały ten sam kanon w każdej ze 144 odpowiedzi. W pytaniach praktycznych ten sam kanon pojawiał się w 12,0% do 0,8% odpowiedzi. Wiedza wchodzi do odpowiedzi tylko przez drzwi, które otwiera pytanie klienta: miejsce, problem, konkretną sytuację. W pytaniach firm źródło, które odpowiadało na praktyczną potrzebę („jak sprawdzić kontrahenta?”), padało w 143 z 4 200 odpowiedzi, a największa firma z tego samego otoczenia w 21.
Model nie poleca więc tego, co zna najlepiej, tylko to, co pasuje do pytania. Dlatego treść marki trzeba budować pod sytuacje klientów, a nie pod jej własny opis.
Szansa na uwagę to jeszcze nie uwaga
Pięć szczebli mówi, co model stawia przed oczami klienta. Co klient naprawdę przeczyta i przetworzy, pokazują dopiero metody z udziałem człowieka, np. ankieta albo eye tracking na próbach odpowiedzi. Dopiero tam zaczyna się uwaga w ścisłym sensie. W reklamie część uwagi szacuje się z sygnałów danych, takich jak czas ekspozycji czy przewijanie. W odpowiedzi modelu te sygnały ma wyłącznie platforma, która ją wyświetla, więc z zewnątrz da się odczytać tylko treść odpowiedzi. Platformy zaczynają się tymi sygnałami dzielić, a o tym, co z takiego licznika da się wyczytać, piszę w tekście o liczniku platformy. Droga do uwagi w kanale AI ma więc cztery kroki.
Po pierwsze, pytania bez nazwy marki: stały zestaw pytań klientów, wiele prób, wersja i data modelu przy każdym wyniku. Po drugie, pięć szczebli odczytanych z treści odpowiedzi, czyli szansa na uwagę. Po trzecie, badanie z udziałem człowieka, czyli potwierdzenie uwagi. Po czwarte, efekt biznesowy: ruch z odpowiedzi, zapytania, sprzedaż i wzrost znajomości marki, połączone z krokami drugim i trzecim.
Obok tej drogi stoi osobne narzędzie: audyt jakości reprezentacji. Model 5P, opisany na blogu Brand Semantics, sprawdza, czy odpowiedź jest prawdziwa i czy wynik jest stabilny. Szczeble szansy na uwagę opisują drogę marki do klienta, a 5P jakość tego, co model po drodze mówi.
Co z tego wynika dla marketera, niezależnie od narzędzia?
Zebrałem to w pięć zasad, które działają bez względu na to, czym mierzysz.
- Mierz tam, gdzie klient nie wymienia marki. Pytania z nazwą marki to echo, nie pomiar. O szansie na uwagę decydują pytania o kategorię, problem i sytuację.
- Nie licz wzmianek. Licz wzmianki z powodem: argumentem, miejscem, porównaniem. Wzmianka bez powodu zajmuje miejsce na liście, ale nie daje klientowi powodu, żeby wybrać.
- Daj modelowi drzwi. Fakt, liczba, porównanie przygotowane pod pytanie klienta wchodzą do odpowiedzi. Tekst o tym, kim jesteście, zwykle nie wchodzi.
- Badaj pytanie odbiorcy w jego języku i kontekście. Tylko wtedy odpowiedź może odesłać do Ciebie, a nie do źródła, które lepiej odpowiada na sytuację klienta.
- Każda liczba z wersją i datą modelu. Pomiar cyklicznie, a płatną reklamę w czacie licz osobno od wzmianki modelu.
Uwaga staje się walutą. W odpowiedzi modelu szanse na nią rozdaje model, a dostaje je marka, która daje mu powód.
Jeżeli chcesz sprawdzić te pięć szczebli dla własnej marki, Semantio zadaje modelom pytania bez nazwy marki i pokazuje, czy model ją wprowadza, z kim zestawia, jak mocno poleca i dokąd odsyła. Możesz zacząć od 7-dniowego okresu próbnego.