Iemand staat op het punt iets te kopen, opent een chat met een taalmodel en vraagt wat te kiezen. Het antwoord komt kant-en-klaar: een paar namen, een korte rechtvaardiging, soms een link. Geen klik op een zoekresultaat, geen bezoek aan de website van het merk, geen spoor in welk dashboard dan ook. Analytics toont niets, maar de beslissing is zojuist genomen. Waar was de aandacht van de klant dan? In het antwoord van het model. En het was het model dat besliste wie die aandacht kreeg.
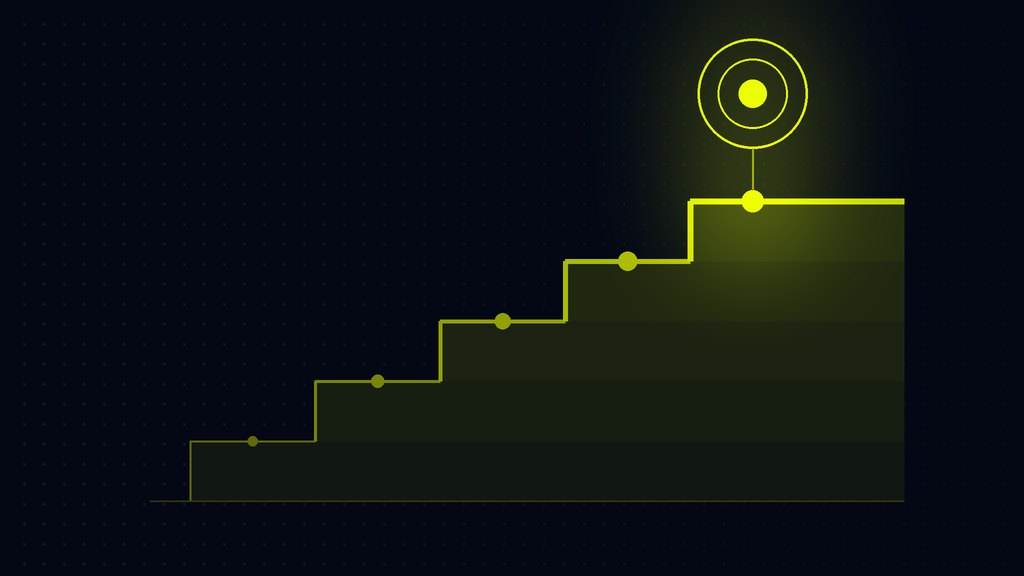
Het taalmodel als influencer: vijf treden die een merk beklimt om de aandacht van de klant te trekken
Vandaag de dag werkt een taalmodel als een influencer, alleen onder andere voorwaarden. Het heeft geen bereik dat u kunt kopen en het tekent geen contracten. Het beslist wie het toont op het moment dat de vraag wordt gesteld, en de aanbeveling bereikt de klant precies op het moment van keuze.
In mijn artikel over de dood van rankings betoogde ik dat de positie in zoekresultaten niet langer de maatstaf is die ertoe doet, maar is vervangen door de waarschijnlijkheid dat een model het merk aanbeveelt. Michał Grzebyk beschreef op deze blog wat merkzichtbaarheid in modelantwoorden betekent. Beide artikelen zijn treden op dezelfde ladder. Hier beklim ik er nog één, want noch alleen aanwezigheid, noch alleen aanbeveling vertelt ons of een merk kans maakt op de aandacht van de klant.
Ik verdeel die kans in vijf treden: aanwezigheid, concurrentie, positie, richting en overdracht. Samen vormen ze de aandachtskansladder. Elke trede is een eenvoudige vraag die een marketeer over zijn eigen merk kan stellen, en samen beschrijven ze wat het model de klant voorschotelt. Of de klant het daadwerkelijk leest, is een aparte kwestie, waar ik aan het einde op terugkom.
Waar komen de cijfers in dit artikel vandaan?
Elk cijfer hier komt uit een eigen onderzoek. Het betreft één specifiek merk, dat ik Merk A noem, en een reeks scenario's die voor zijn situatie zijn opgesteld: 1.400 vragen in 11 talen, gesteld namens persona's uit 12 markten, voorgelegd aan zes modellen (ChatGPT, Gemini, Claude, Perplexity, Grok, DeepSeek). Dat leverde 8.400 beoordeelde antwoorden op, verzameld tussen augustus en oktober 2026.
Deze percentages beschrijven daarom Merk A, zijn vragen en de modelversies van die periode. Ze zijn geen marktnorm, noch een niveau waartegen een ander merk moet worden afgezet. Een andere categorie, andere vragen en andere persona's zullen andere cijfers opleveren. Ik toon ze omdat ze mechanismen illustreren die we ook zien bij het meten van andere merken: de richting van het effect is vergelijkbaar, maar het niveau moet altijd afzonderlijk worden gemeten.
Waarom vertelt één modelantwoord u nog niets?
Neem één vraag uit het onderzoek, gesteld in de taal van een van de markten, zonder merknaam. Zes modellen gaven zes verschillende antwoorden. In twee verscheen Merk A helemaal niet. In één kwam het als vierde, geïntroduceerd als "een verrassing". In een ander kreeg het een eigen sectie, in weer een ander een enkele vermelding in een zin over levenskosten, en in het laatste kwam het als derde op de lijst.
Vier van de zes modellen brachten het merk in hun antwoord. Is dat een goed resultaat? Eén vraag kan het u niet vertellen. Over de hele groep vergelijkbare vragen bracht het model Merk A in 45,1% van de 324 antwoorden, dus in minder dan één op de twee antwoorden. Een enkel antwoord is als één worp met een geladen dobbelsteen: de dobbelsteen heeft zijn neigingen, maar de uitkomst van één worp is toeval. Alleen een vaste reeks vragen, vele malen gesteld, met de modelversie en datum bij elk cijfer, onthult die neigingen.
Dit onderzoek toont nog iets. De verschillen tussen vraagtypen waren groter dan de verschillen tussen modellen. Wat de klant vraagt, weegt zwaarder dan welk model hij gebruikt. Daarom begint de voorbereiding van een onderzoek met een nauwkeurige beschrijving van het merk en van de situaties waarin klanten ernaar zoeken. We behandelen dit in onze serie over het voorbereiden van een onderzoek naar modelantwoorden.
Vijf vragen die de moeite waard zijn om over uw eigen merk te stellen
Brengt het model het merk zelf in het antwoord?
De eerste trede is aanwezigheid. Wanneer de merknaam in de vraag staat, praat het model er bijna altijd over: in het Merk A-onderzoek, in 99,9% van de antwoorden. Dat is echter een echo, geen meting. De echte test begint waar de klant de merknaam niet noemt, want alleen daar kiest het model zelf wie het een kans geeft.
In 1.452 antwoorden op vragen zonder de naam van Merk A, bracht het model het in 72,4% van de gevallen. Dat gemiddelde verbergt grote verschillen. In vragen van particulieren (waar de volgende cijfers naar verwijzen, tenzij ik anders zeg) beperkt tot het segment waarin het merk concurreert, verscheen het in 91,7% van de 552 antwoorden. In algemene vragen over de hele categorie, in 45,1% van de 324. In vragen die helemaal niet naar de categorie wezen, in 20,0% van de 90. Aanwezigheid is dus geen eigenschap van het merk. Het is een eigenschap van een paar: het merk en de vraag.
Met wie deelt het merk het antwoord?
De tweede trede is concurrentie. Een model wijst zelden naar één enkel merk. In 1.044 antwoorden op vragen zonder de naam van Merk A, noemde het gemiddeld bijna zes andere opties, en Merk A was de enige suggestie in slechts 0,4% van de gevallen. In algemene vragen werd de lijst geopend door een leider, genoemd in 58,0% van de antwoorden. Merk A kwam als tweede (45,1%), met vier opties dicht daarachter, elk genoemd in 38-41% van de antwoorden.
De conclusie is eenvoudig: in het antwoord van een model concurreert een merk niet met één rivaal, maar met een hele lijst. Het model dat die lijst samenstelt, beslist wie de klant naast uw merk zal zien.
Hoe hoog staat het merk in het antwoord?
De derde trede is positie: bovenaan het antwoord of in de achtste paragraaf. In het voorbeeld met één vraag stond Merk A één keer derde en één keer vierde. Het is verleidelijk om dat om te zetten in een ranking. Toch toont het Merk A-onderzoek aan dat wanneer de merknaam niet in de vraag staat, de positie verandert van antwoord tot antwoord, zelfs wanneer dezelfde vraag op dezelfde dag wordt herhaald.
Een enkele positie is dus geen resultaat. Het resultaat is hoe vaak het merk de opening van het antwoord bereikt over een vaste reeks vragen. Wanneer de merknaam in de vraag staat, opent het model zijn antwoord er bijna altijd mee, maar dat is, nogmaals, slechts een echo.
Beveelt het model aan, vermeldt het alleen of raadt het af?
De vierde trede is richting. Toen het model Merk A zelf in het antwoord bracht, beval het het in 55,9% van de gevallen duidelijk aan. Het raadde het bijna nooit af (1,7%), maar in vier van de tien antwoorden vermeldde het het alleen, zonder enige aanbeveling. Michał Grzebyk legt het verschil uit tussen een vermelding en een aanbeveling in een apart artikel.
Het meest interessante is dat het vraagtype hier andersom werkt dan bij aanwezigheid. In specifieke vragen verschijnt Merk A bijna altijd, maar het wordt slechts in 47,0% van de antwoorden aanbevolen. In algemene vragen verschijnt het minder vaak, maar wanneer het verschijnt, wordt het in 62,3% aanbevolen. Aanwezigheid uit verplichting is niet hetzelfde als aanwezigheid uit keuze. Het model kiest een merk wanneer het er een argument voor heeft, en een vermeldingsteller kan de twee situaties niet van elkaar onderscheiden.
Waar stuurt het model de klant heen?
De vijfde trede is overdracht. Dit is waar het kanaal van het model eindigt en uw website begint. Adressen die modellen uit het geheugen gaven, leidden in 49,5% van de gevallen naar pagina's die verband hielden met Merk A. Bronnen die via live zoeken werden gevonden, leidden daar in 22,4% van de gevallen heen. Dit zijn twee verschillende werkmodi en twee afzonderlijke cijfers, die ik niet combineer tot één.
Het lezen van de antwoorden laat zien waarom. Het model citeert een bron die aansluit bij de situatie van de vrager, in hun taal en context. Het citeert geen tekst over wie het merk is. Voor elke contentuitgever is dat een belangrijk signaal: verkeer van modellen gaat naar de pagina die de vraag van de klant beantwoordt.
De kans op aandacht is een momentopname
De vijf treden beschrijven antwoorden van een specifieke dag en een specifieke modelversie. In het Merk A-onderzoek verschoven nieuwere modelversies het aandeel van duidelijke aanbevelingen met meer dan tien punten in zeven weken, in beide richtingen en zonder enige campagne. Eén model, in zijn nieuwe versie, stopte met het noemen van het merk in een antwoord waar het eerder op de lijst had gestaan. Een ander, in zijn nieuwe versie, plaatste het in de eerste zin.
Dit soort verschuivingen verandert de betekenis van elke eenmalige audit. Een cijfer zonder modelversie en datum heeft geen adres, en een meting van een kwartaal geleden vertelt u alleen hoe het toen was. De kans op aandacht moet regelmatig worden gecontroleerd, op dezelfde reeks vragen.
Waarom is een bekend merk nog geen gezien merk?
Rechtstreeks gevraagd naar de bekendste namen die met Merk A geassocieerd worden, gaven de modellen in elk van de 144 antwoorden dezelfde canon. In praktische vragen verscheen diezelfde canon in tussen 12,0% en 0,8% van de antwoorden. Kennis komt alleen een antwoord binnen via een deur die de vraag van de klant opent: een plaats, een probleem, een specifieke situatie. In zakelijke vragen verscheen de bron die aan een praktische behoefte voldeed ("hoe controleer ik een zakenpartner?") in 143 van de 4.200 antwoorden, terwijl het grootste bedrijf in hetzelfde landschap in 21 verscheen.
Het model beveelt dus niet aan wat het het beste kent. Het beveelt aan wat bij de vraag past. Daarom moet de content van een merk worden opgebouwd rond de situaties van klanten, niet rond de eigen beschrijving.
Een kans op aandacht is nog geen aandacht
De vijf treden vertellen u wat het model de klant voorschotelt. Wat de klant daadwerkelijk leest en verwerkt, wordt alleen getoond door methoden waarbij mensen betrokken zijn, zoals een enquête of eye-tracking op steekproeven van antwoorden. Dat is waar aandacht, in strikte zin, begint. In reclame wordt een deel van de aandacht geschat op basis van datasignalen zoals blootstellingstijd of scrollen. In het antwoord van een model behoren die signalen uitsluitend toe aan het platform dat het weergeeft, dus van buitenaf kan alleen de inhoud van het antwoord worden gelezen. De route naar aandacht in het AI-kanaal heeft daarom vier stappen.
Ten eerste, vragen zonder de merknaam: een vaste reeks klantvragen, vele runs, en de modelversie en datum bij elk resultaat. Ten tweede, de vijf treden afgelezen uit de inhoud van de antwoorden, wat de kans op aandacht is. Ten derde, onderzoek waarbij mensen betrokken zijn, wat aandacht bevestigt. Ten vierde, het bedrijfsresultaat: verkeer van antwoorden, aanvragen, verkopen en merkbekendheid, gekoppeld aan stap twee en drie.
Naast deze route zit een aparte tool: een audit van de representatiekwaliteit. Het 5P-model, beschreven op de Brand Semantics blog, controleert of een antwoord waar is en of het resultaat stabiel is. De aandachtskansladder beschrijft de route van het merk naar de klant, terwijl 5P de kwaliteit beschrijft van wat het model onderweg zegt.
Wat volgt voor een marketeer, ongeacht de tool?
Ik heb het samengevat in vijf principes die gelden, ongeacht waarmee u meet.
- Meet waar de klant de merknaam niet noemt. Vragen die de merknaam bevatten zijn een echo, geen meting. De kans op aandacht wordt bepaald door vragen over de categorie, het probleem en de situatie.
- Tel geen vermeldingen. Tel vermeldingen met een reden: een argument, een plaats, een vergelijking. Een vermelding zonder reden neemt een plek op de lijst in, maar geeft de klant geen reden om te kiezen.
- Geef het model een deur. Een feit, een getal of een vergelijking die is voorbereid op de vraag van de klant, komt in het antwoord. Een tekst over wie u bent meestal niet.
- Bestudeer de vraag van het publiek in hun taal en context. Alleen dan kan het antwoord mensen naar u sturen, in plaats van naar een bron die beter bij de situatie van de klant past.
- Elk cijfer met een modelversie en datum. Meet regelmatig en tel betaalde advertenties in de chat apart van de vermelding van het model.
Aandacht wordt een valuta. In het antwoord van een model worden de kansen om het te winnen uitgedeeld door het model, en ze gaan naar het merk dat het een reden geeft.
Als u deze vijf treden voor uw eigen merk wilt controleren, stelt Semantio modellen vragen zonder de merknaam en laat zien of het model het merk erin brengt, met wie het wordt vergeleken, hoe sterk het wordt aanbevolen en waar het model mensen vervolgens heen stuurt. U kunt beginnen met een 7-daagse proefperiode.
Lees ook: ChatGPT toont hoe vaak een merk in antwoorden verscheen, maar niet waarom