Nogen er ved at købe, åbner en chat med en sprogmodel og spørger, hvad de skal vælge. Svaret kommer færdigt: et par navne, en kort begrundelse, nogle gange et link. Intet klik på et søgeresultat, intet besøg på brandets hjemmeside, intet spor i noget dashboard. Analysen viser intet, men beslutningen er netop truffet. Så hvor var kundens opmærksomhed? I modellens svar. Og det var modellen, der besluttede, hvem der fik den.
Sprogmodellen som influencer: fem trin et brand klatrer for at nå kundens opmærksomhed
I dag fungerer en sprogmodel som en influencer, blot på andre vilkår. Den har ingen rækkevidde, du kan købe, og den underskriver ingen kontrakter. Den beslutter, hvem den skal vise i det øjeblik spørgsmålet stilles, og dens anbefaling når kunden præcis i valgets øjeblik.
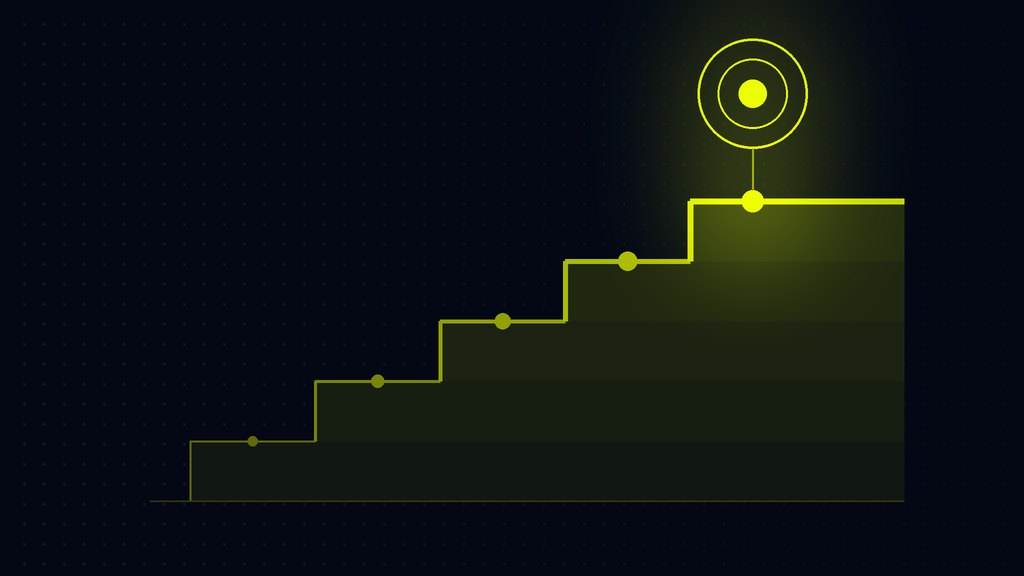
I min artikel om rangeringernes død argumenterede jeg for, at position i søgeresultater var holdt op med at være det afgørende mål, erstattet af sandsynligheden for, at en model anbefaler brandet. Michał Grzebyk beskrev på denne blog hvad brand-synlighed i modelsvar betyder. Begge artikler er trin på den samme stige. Her klatrer jeg et trin mere, for hverken tilstedeværelse alene eller anbefaling alene fortæller os, om et brand har en chance for kundens opmærksomhed.
Jeg opdeler denne chance i fem trin: tilstedeværelse, konkurrence, position, retning og overlevering. Sammen danner de opmærksomheds-chanceladderen. Hvert trin er et simpelt spørgsmål, en marketingmedarbejder kan stille om sit eget brand, og sammen beskriver de, hvad modellen præsenterer for kunden. Om kunden faktisk læser det, er en separat sag, som jeg vender tilbage til til sidst.
Hvor kommer tallene i denne artikel fra?
Hvert tal her stammer fra en enkelt af vores egne undersøgelser. Den vedrører et specifikt brand, som jeg kalder Brand A, og et sæt scenarier bygget til dets situation: 1.400 spørgsmål på 11 sprog, stillet på vegne af personaer fra 12 markeder, til seks modeller (ChatGPT, Gemini, Claude, Perplexity, Grok, DeepSeek). Det producerede 8.400 vurderede svar, indsamlet mellem august og oktober 2026.
Disse procenter beskriver derfor Brand A, dets spørgsmål og modelversionerne fra den periode. De er ikke en markedsnorm, ej heller et niveau at holde et andet brand op imod. En anden kategori, andre spørgsmål og andre personaer vil producere andre tal. Jeg viser dem, fordi de illustrerer mekanismer, vi også ser, når vi måler andre brands: effekternes retning er ens, men niveauet skal altid måles separat.
Hvorfor fortæller et enkelt modelsvar dig intet endnu?
Tag et spørgsmål fra undersøgelsen, stillet på sproget på et af markederne, uden noget brandnavn. Seks modeller gav seks forskellige svar. I to optrådte Brand A slet ikke. I et kom det på fjerdepladsen, introduceret som "en overraskelse". I et andet fik det sin egen sektion, i et andet en enkelt omtale i en sætning om leveomkostninger, og i det sidste kom det på tredjepladsen på listen.
Fire ud af seks modeller inkluderede brandet i deres svar. Er det et godt resultat? Et enkelt spørgsmål kan ikke fortælle dig det. På tværs af hele gruppen af lignende spørgsmål inkluderede modellen Brand A i 45,1% af 324 svar, altså i færre end ét svar ud af to. Et enkelt svar er som et enkelt kast med en vægtet terning: terningen har sine tendenser, men udfaldet af et enkelt kast er tilfældigt. Kun et fast sæt spørgsmål, stillet mange gange, med modelversion og dato ved hvert tal, afslører disse tendenser.
Denne undersøgelse viser endnu en ting. Forskellene mellem spørgsmålstyper var større end forskellene mellem modeller. Hvad kunden spørger om, vejer mere end hvilken model de bruger. Derfor starter forberedelsen af en undersøgelse med en præcis beskrivelse af brandet og af de situationer, hvor kunder leder efter det. Vi dækker dette i vores serie om forberedelse af en undersøgelse af modelsvar.
Fem spørgsmål, der er værd at stille om dit eget brand
Inkluderer modellen selv brandet i svaret?
Det første trin er tilstedeværelse. Når brandnavnet er i spørgsmålet, taler modellen næsten altid om det: i Brand A-undersøgelsen i 99,9% af svarene. Det er dog et ekko, ikke en måling. Den virkelige test begynder, hvor kunden ikke nævner brandet, for kun der vælger modellen selv, hvem den vil give en chance.
I 1.452 svar på spørgsmål uden Brand A's navn inkluderede modellen det i 72,4% af tilfældene. Dette gennemsnit skjuler store forskelle. I spørgsmål fra privatpersoner (som de følgende tal henviser til, medmindre jeg siger andet), indsnævret til det segment, hvor brandet konkurrerer, optrådte det i 91,7% af 552 svar. I generelle spørgsmål om hele kategorien, i 45,1% af 324. I spørgsmål, der slet ikke pegede på kategorien, i 20,0% af 90. Tilstedeværelse er altså ikke en egenskab ved brandet. Det er en egenskab ved et par: brandet og spørgsmålet.
Hvem deler brandet svaret med?
Det andet trin er konkurrence. En model peger sjældent på et enkelt brand. I 1.044 svar på spørgsmål uden Brand A's navn listede den i gennemsnit næsten seks andre muligheder, og Brand A var det eneste forslag i blot 0,4% af tilfældene. I generelle spørgsmål blev listen åbnet af en leder, nævnt i 58,0% af svarene. Brand A kom på andenpladsen (45,1%), med fire muligheder tæt bagved, hver nævnt i 38-41% af svarene.
Konklusionen er enkel: i et modelsvar konkurrerer et brand ikke med én rival, men med en hel liste. Modellen, der udarbejder denne liste, beslutter, hvem kunden vil se ved siden af dit brand.
Hvor højt står brandet i svaret?
Det tredje trin er position: øverst i svaret eller i ottende afsnit. I eksemplet med et enkelt spørgsmål stod Brand A en gang på tredjepladsen og en gang på fjerdepladsen. Det er fristende at omdanne det til en rangering. Alligevel viser Brand A-undersøgelsen, at når brandnavnet ikke er i spørgsmålet, ændres dets position fra svar til svar, selv når det samme spørgsmål gentages samme dag.
En enkelt position er altså ikke et resultat. Resultatet er, hvor ofte brandet når åbningen af svaret på tværs af et fast sæt spørgsmål. Når brandnavnet er i spørgsmålet, åbner modellen næsten altid sit svar med det, men det er igen kun et ekko.
Anbefaler modellen, nævner den blot eller fraråder den?
Det fjerde trin er retning. Når modellen selv inkluderede Brand A i svaret, anbefalede den det tydeligt i 55,9% af tilfældene. Den frarådede det næsten aldrig (1,7%), men i fire ud af ti svar nævnte den det blot, uden nogen anbefaling overhovedet. Michał Grzebyk forklarer forskellen mellem en omtale og en anbefaling i en separat artikel.
Det mest interessante er, at spørgsmålstypen her fungerer modsat af, hvad den gør for tilstedeværelse. I indsnævrede spørgsmål optræder Brand A næsten altid, men det anbefales kun i 47,0% af svarene. I generelle spørgsmål optræder det sjældnere, men når det optræder, anbefales det i 62,3%. Tilstedeværelse af pligt er ikke det samme som tilstedeværelse af valg. Modellen vælger et brand, når den har et argument for det, og en omtale-tæller kan ikke skelne de to situationer fra hinanden.
Hvor sender modellen kunden hen?
Det femte trin er overlevering. Det er her, modellens kanal slutter, og din hjemmeside begynder. Adresser, som modellerne gav fra hukommelsen, førte til sider forbundet med Brand A i 49,5% af tilfældene. Kilder fundet via live-søgning førte dertil i 22,4%. Dette er to forskellige arbejdsformer og to separate tal, som jeg ikke kombinerer til ét.
Læsning af svarene viser hvorfor. Modellen citerer en kilde, der adresserer spørgerens situation, på deres sprog og i deres kontekst. Den citerer ikke en tekst om, hvem brandet er. For enhver indholdsudgiver er det et vigtigt signal: trafik fra modeller går til den side, der besvarer kundens spørgsmål.
Chancen for opmærksomhed er et øjebliksbillede
De fem trin beskriver svar fra en specifik dag og en specifik modelversion. I Brand A-undersøgelsen flyttede nyere modelversioner andelen af klare anbefalinger med mere end ti point på syv uger, i begge retninger og uden nogen kampagne. En model, i sin nye version, stoppede med at nævne brandet i et svar, hvor det tidligere havde været på listen. En anden, i sin nye version, placerede det i den første sætning.
Denne form for drift ændrer betydningen af enhver engangsaudit. Et tal uden en modelversion og dato har ingen adresse, og en måling fra et kvartal siden fortæller dig kun, hvordan tingene var. Chancen for opmærksomhed skal kontrolleres regelmæssigt, på det samme sæt spørgsmål.
Hvorfor er et velkendt brand endnu ikke et set brand?
Spurgt direkte om de bedst kendte navne forbundet med Brand A, gav modellerne den samme kanon i hvert af 144 svar. I praktiske spørgsmål optrådte den samme kanon mellem 12,0% og 0,8% af svarene. Viden kommer kun ind i et svar gennem en dør, som kundens spørgsmål åbner: et sted, et problem, en specifik situation. I forretningsspørgsmål optrådte den kilde, der opfyldte et praktisk behov ("hvordan tjekker jeg en forretningspartner?"), i 143 af 4.200 svar, mens den største virksomhed i samme landskab optrådte i 21.
Så modellen anbefaler ikke det, den kender bedst. Den anbefaler det, der passer til spørgsmålet. Derfor skal et brands indhold bygges op omkring kundernes situationer, ikke omkring dets egen beskrivelse.
En chance for opmærksomhed er endnu ikke opmærksomhed
De fem trin fortæller dig, hvad modellen præsenterer for kunden. Hvad kunden faktisk læser og behandler, vises kun af metoder, der involverer mennesker, såsom en undersøgelse eller eye-tracking på prøver af svar. Det er her, opmærksomhed, i streng forstand, begynder. I reklamer estimeres en del af opmærksomheden ud fra datasignaler som eksponeringstid eller scrolling. I et modelsvar tilhører disse signaler udelukkende den platform, der viser det, så udefra kan kun indholdet af svaret læses. Vejen til opmærksomhed i AI-kanalen har derfor fire trin.
Først, spørgsmål uden brandnavnet: et fast sæt kundespørgsmål, mange kørsler, og modelversion og dato ved hvert resultat. For det andet, de fem trin læst ud fra indholdet af svarene, hvilket er chancen for opmærksomhed. For det tredje, forskning, der involverer mennesker, som bekræfter opmærksomhed. For det fjerde, forretningsresultatet: trafik fra svar, forespørgsler, salg og brand-løft, knyttet til trin to og tre.
Ved siden af denne rute sidder et separat værktøj: en audit af repræsentationskvalitet. 5P-modellen, beskrevet på Brand Semantics-bloggen, kontrollerer, om et svar er sandt, og om resultatet er stabilt. Opmærksomheds-chanceladderen beskriver brandets vej til kunden, mens 5P beskriver kvaliteten af, hvad modellen siger undervejs.
Hvad følger for en marketingmedarbejder, uanset værktøjet?
Jeg har samlet det i fem principper, der gælder, uanset hvad du måler med.
- Mål, hvor kunden ikke nævner brandet. Spørgsmål, der inkluderer brandnavnet, er et ekko, ikke en måling. Chancen for opmærksomhed afgøres af spørgsmål om kategorien, problemet og situationen.
- Tæl ikke omtaler. Tæl omtaler med en grund: et argument, et sted, en sammenligning. En omtale uden grund tager en plads på listen, men giver kunden ingen grund til at vælge.
- Giv modellen en dør. Et faktum, et tal eller en sammenligning forberedt til kundens spørgsmål kommer ind i svaret. En tekst om, hvem du er, gør det normalt ikke.
- Studer publikums spørgsmål på deres sprog og i deres kontekst. Først da kan svaret sende folk til dig, snarere end til en kilde, der passer bedre til kundens situation.
- Hvert tal med en modelversion og dato. Mål regelmæssigt, og tæl betalt annoncering i chatten separat fra modellens omtale.
Opmærksomhed er ved at blive en valuta. I et modelsvar uddeles chancerne for at vinde den af modellen, og de går til det brand, der giver den en grund.
Hvis du vil tjekke disse fem trin for dit eget brand, stiller Semantio modeller spørgsmål uden brandnavnet og viser, om modellen inkluderer brandet, hvem det er sat sammen med, hvor stærkt det anbefales, og hvor modellen sender folk hen næste gang. Du kan starte med en 7-dages prøveperiode.
Læs også: ChatGPT vil vise, hvor ofte et brand optræder i svar. Men ikke hvorfor.