Někdo se chystá nakoupit, otevře chat s jazykovým modelem a zeptá se, co si vybrat. Odpověď dorazí hotová: několik jmen, krátké zdůvodnění, někdy odkaz. Žádné kliknutí na výsledek vyhledávání, žádná návštěva webových stránek značky, žádná stopa v žádném dashboardu. Analytika nic neukazuje, přesto bylo právě učiněno rozhodnutí. Kde tedy byla pozornost zákazníka? V odpovědi modelu. A byl to model, který rozhodl, kdo ji získá.
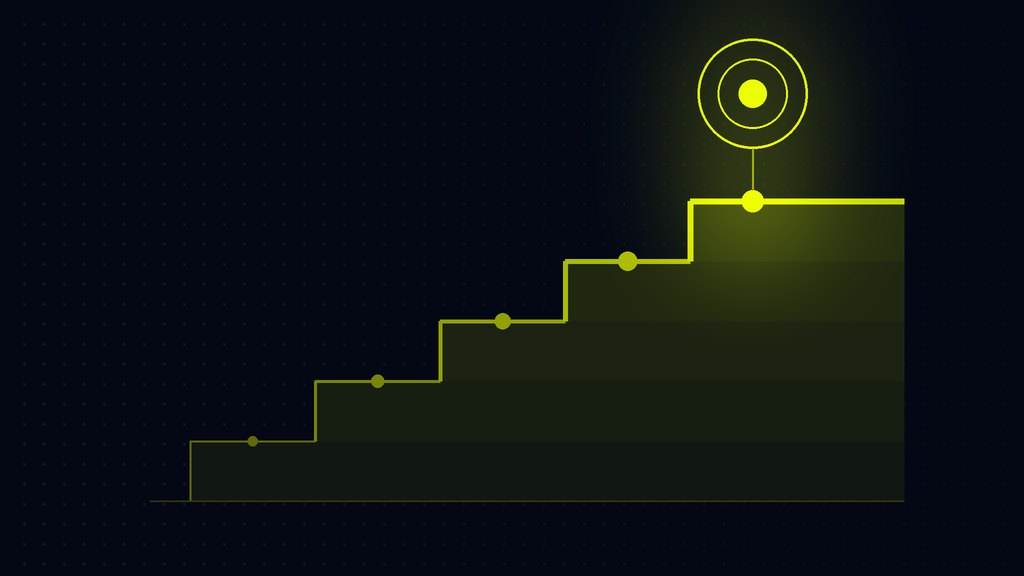
Jazykový model jako influencer: pět příček, které značka zdolává, aby získala pozornost zákazníka
Dnes jazykový model funguje jako influencer, jen za jiných podmínek. Nemá dosah, který byste si mohli koupit, a nepodepisuje žádné smlouvy. Rozhoduje, koho ukáže v okamžiku, kdy je položena otázka, a jeho doporučení se dostane k zákazníkovi přesně v okamžiku volby.
Ve svém článku o smrti žebříčků jsem tvrdil, že pozice ve výsledcích vyhledávání přestala být měřítkem, na kterém záleží, a byla nahrazena pravděpodobností, že model značku doporučí. Michał Grzebyk na tomto blogu popsal, co znamená viditelnost značky v odpovědích modelu. Oba články jsou příčkami na stejném žebříku. Zde se posouvám o jednu dál, protože ani samotná přítomnost, ani samotné doporučení nám neřeknou, zda má značka šanci na pozornost zákazníka.
Tuto šanci rozkládám na pět příček: přítomnost, konkurence, pozice, směr a předání. Společně tvoří žebřík šance na pozornost. Každá příčka je jednoduchá otázka, kterou si marketér může položit o své vlastní značce, a společně popisují, co model zákazníkovi předkládá. Zda si to zákazník skutečně přečte, je samostatná záležitost, ke které se vrátím na konci.
Odkud pocházejí čísla v tomto článku?
Každý údaj zde pochází z jedné naší vlastní studie. Týká se jedné konkrétní značky, kterou nazývám Značka A, a sady scénářů vytvořených pro její situaci: 1 400 otázek v 11 jazycích, položených jménem person z 12 trhů, šesti modelům (ChatGPT, Gemini, Claude, Perplexity, Grok, DeepSeek). To vyprodukovalo 8 400 posouzených odpovědí, shromážděných mezi srpnem a říjnem 2026.
Tyto procenta proto popisují Značku A, její otázky a verze modelů z tohoto období. Nejsou tržní normou, ani úrovní, proti které by se měla držet jiná značka. Jiná kategorie, jiné otázky a jiné persony vyprodukují jiná čísla. Ukazuji je, protože ilustrují mechanismy, které vidíme i při měření jiných značek: směr efektu je podobný, ale úroveň je vždy třeba měřit samostatně.
Proč vám jedna odpověď modelu zatím nic neřekne?
Vezměte jednu otázku ze studie, položenou v jazyce jednoho z trhů, bez jakéhokoli názvu značky. Šest modelů dalo šest různých odpovědí. Ve dvou se Značka A vůbec neobjevila. V jedné se umístila na čtvrtém místě, představena jako „překvapení“. V jiné dostala vlastní sekci, v další jedinou zmínku ve větě o životních nákladech a v poslední se umístila na třetím místě v seznamu.
Čtyři modely z šesti zahrnuly značku do své odpovědi. Je to dobrý výsledek? Jedna otázka vám to neřekne. V celé skupině podobných otázek model zahrnul Značku A do 45,1 % z 324 odpovědí, tedy do méně než jedné odpovědi ze dvou. Jedna odpověď je jako jeden hod zatíženou kostkou: kostka má své tendence, ale výsledek jednoho hodu je náhoda. Pouze pevně stanovená sada otázek, položená mnohokrát, s verzí modelu a datem u každého údaje, odhalí tyto tendence.
Tato studie ukazuje ještě jednu věc. Rozdíly mezi typy otázek byly větší než rozdíly mezi modely. To, co se zákazník ptá, váží více než to, jaký model používá. Proto příprava studie začíná přesným popisem značky a situací, ve kterých ji zákazníci hledají. Tomu se věnujeme v naší sérii o přípravě studie odpovědí modelu.
Pět otázek, které stojí za to si položit o své vlastní značce
Zahrne model značku do odpovědi sám?
První příčka je přítomnost. Když je název značky v otázce, model o ní mluví téměř vždy: ve studii Značky A v 99,9 % odpovědí. To je však spíše ozvěna, nikoli měření. Skutečný test začíná tam, kde zákazník značku nepojmenuje, protože pouze tam si model sám vybírá, komu dá šanci.
Ve 1 452 odpovědích na otázky bez názvu Značky A ji model zahrnul v 72,4 % případů. Tento průměr skrývá velké rozdíly. V otázkách od soukromých osob (na které se vztahují následující údaje, pokud neřeknu jinak), zúžených na segment, kde značka konkuruje, se objevila v 91,7 % z 552 odpovědí. V obecných otázkách o celé kategorii v 45,1 % z 324. V otázkách, které vůbec neukazovaly na kategorii, v 20,0 % z 90. Přítomnost tedy není vlastností značky. Je to vlastnost páru: značky a otázky.
S kým značka sdílí odpověď?
Druhá příčka je konkurence. Model zřídka ukazuje na jedinou značku. V 1 044 odpovědích na otázky bez názvu Značky A uvedl v průměru téměř šest dalších možností a Značka A byla jediným návrhem pouze v 0,4 % případů. V obecných otázkách seznam otevřel lídr, jmenovaný v 58,0 % odpovědí. Značka A se umístila na druhém místě (45,1 %), se čtyřmi možnostmi těsně za ní, každá jmenovaná v 38–41 % odpovědí.
Závěr je jednoduchý: v odpovědi modelu značka nekonkuruje jednomu rivalovi, ale celému seznamu. Model, který tento seznam sestavuje, rozhoduje, koho zákazník uvidí vedle vaší značky.
Jak vysoko se značka v odpovědi nachází?
Třetí příčka je pozice: na začátku odpovědi nebo v osmém odstavci. V příkladu s jednou otázkou se Značka A jednou umístila na třetím a jednou na čtvrtém místě. Je lákavé to proměnit v žebříček. Studie Značky A však ukazuje, že když název značky není v otázce, její pozice se mění z odpovědi na odpověď, i když je stejná otázka opakována ve stejný den.
Jedna pozice tedy není výsledek. Výsledkem je, jak často se značka dostane na začátek odpovědi napříč pevně stanovenou sadou otázek. Když je název značky v otázce, model téměř vždy začíná svou odpověď s ním, ale to je opět jen ozvěna.
Doporučuje model, pouze zmiňuje nebo odrazuje?
Čtvrtá příčka je směr. Když model sám zahrnul Značku A do odpovědi, jasně ji doporučil v 55,9 % případů. Téměř nikdy ji nedoporučil (1,7 %), ale ve čtyřech odpovědích z deseti ji pouze zmínil, bez jakéhokoli doporučení. Michał Grzebyk vysvětluje rozdíl mezi zmínkou a doporučením v samostatném článku.
Nejzajímavější je, že typ otázky zde funguje opačně než u přítomnosti. V zúžených otázkách se Značka A objevuje téměř vždy, přesto je doporučena pouze ve 47,0 % odpovědí. V obecných otázkách se objevuje méně často, ale když se objeví, je doporučena v 62,3 %. Přítomnost z povinnosti není totéž co přítomnost z volby. Model si vybírá značku, když pro ni má argument, a počítadlo zmínek nedokáže tyto dvě situace rozlišit.
Kam model zákazníka pošle?
Pátá příčka je předání. Zde končí kanál modelu a začíná vaše webová stránka. Adresy, které modely uvedly z paměti, vedly na stránky spojené se Značkou A v 49,5 % případů. Zdroje nalezené prostřednictvím živého vyhledávání tam vedly v 22,4 %. Jedná se o dva různé režimy práce a dvě samostatná čísla, která nespojuji do jednoho.
Čtení odpovědí ukazuje proč. Model cituje zdroj, který se zabývá situací tazatele, v jeho jazyce a kontextu. Necituje text o tom, kdo je značka. Pro každého vydavatele obsahu je to důležitý signál: provoz z modelů směřuje na stránku, která odpovídá na otázku zákazníka.
Šance na pozornost je snímek
Pět příček popisuje odpovědi z konkrétního dne a konkrétní verze modelu. Ve studii Značky A novější verze modelů posunuly podíl jasných doporučení o více než deset bodů za sedm týdnů, v obou směrech a bez jakékoli kampaně. Jeden model ve své nové verzi přestal jmenovat značku v odpovědi, kde dříve byla na seznamu. Jiný ve své nové verzi ji umístil do první věty.
Tento druh posunu mění význam jakéhokoli jednorázového auditu. Údaj bez verze modelu a data nemá adresu a měření z před čtvrtletí vám pouze řekne, jak se věci měly. Šance na pozornost je třeba pravidelně kontrolovat, na stejném souboru otázek.
Proč známá značka ještě není viděná značka?
Když se modely přímo zeptaly na nejznámější jména spojená se Značkou A, daly stejný kánon ve všech 144 odpovědích. V praktických otázkách se tentýž kánon objevil mezi 12,0 % a 0,8 % odpovědí. Znalost vstupuje do odpovědi pouze dveřmi, které otevírá otázka zákazníka: místo, problém, konkrétní situace. V obchodních otázkách se zdroj, který splňoval praktickou potřebu („jak zkontroluji obchodního partnera?“), objevil ve 143 z 4 200 odpovědí, zatímco největší společnost ve stejném prostředí se objevila ve 21.
Model tedy nedoporučuje to, co zná nejlépe. Doporučuje to, co odpovídá otázce. Proto musí být obsah značky postaven kolem situací zákazníků, nikoli kolem jejího vlastního popisu.
Šance na pozornost ještě není pozornost
Pět příček vám řekne, co model zákazníkovi předkládá. Co zákazník skutečně čte a zpracovává, ukazují pouze metody zahrnující lidi, jako je průzkum nebo sledování očí na vzorcích odpovědí. Tam začíná pozornost v přísném smyslu. V reklamě se část pozornosti odhaduje z datových signálů, jako je doba expozice nebo posouvání. V odpovědi modelu tyto signály patří výhradně platformě, která ji zobrazuje, takže zvenčí lze číst pouze obsah odpovědi. Cesta k pozornosti v kanálu AI má proto čtyři kroky.
Zaprvé, otázky bez názvu značky: pevně stanovená sada zákaznických otázek, mnoho běhů a verze modelu a datum u každého výsledku. Zadruhé, pět příček čtených z obsahu odpovědí, což je šance na pozornost. Zatřetí, výzkum zahrnující lidi, který potvrzuje pozornost. Začtvrté, obchodní výsledek: provoz z odpovědí, dotazy, prodeje a zvýšení povědomí o značce, spojené s kroky dva a tři.
Vedle této cesty sedí samostatný nástroj: audit kvality reprezentace. Model 5P, popsaný na blogu Brand Semantics, kontroluje, zda je odpověď pravdivá a zda je výsledek stabilní. Žebřík šance na pozornost popisuje cestu značky k zákazníkovi, zatímco 5P popisuje kvalitu toho, co model říká po cestě.
Co z toho plyne pro marketéra, ať už s jakýmkoli nástrojem?
Shromáždil jsem to do pěti principů, které platí bez ohledu na to, čím měříte.
- Měřte tam, kde zákazník značku nepojmenuje. Otázky, které obsahují název značky, jsou ozvěnou, nikoli měřením. Šance na pozornost je rozhodována otázkami o kategorii, problému a situaci.
- Nepočítejte zmínky. Počítejte zmínky s důvodem: argumentem, místem, srovnáním. Zmínka bez důvodu zabírá místo na seznamu, ale nedává zákazníkovi důvod k výběru.
- Dejte modelu dveře. Fakt, číslo nebo srovnání připravené pro otázku zákazníka se dostane do odpovědi. Text o tom, kdo jste, obvykle ne.
- Studujte otázku publika v jejich jazyce a kontextu. Pouze tehdy může odpověď poslat lidi k vám, spíše než ke zdroji, který lépe odpovídá situaci zákazníka.
- Každý údaj s verzí modelu a datem. Měřte pravidelně a placenou reklamu v chatu počítejte odděleně od zmínky modelu.
Pozornost se stává měnou. V odpovědi modelu jsou šance na její získání rozdávány modelem a jdou značce, která mu dá důvod.
Pokud chcete zkontrolovat těchto pět příček pro svou vlastní značku, Semantio klade modelům otázky bez názvu značky a ukazuje, zda model značku zahrne, s kým je postavena, jak silně je doporučena a kam model lidi dále posílá. Můžete začít se 7denní zkušební verzí.
Přečtěte si také: ChatGPT ukáže, jak často se značka objevila v odpovědích. Neukáže proč